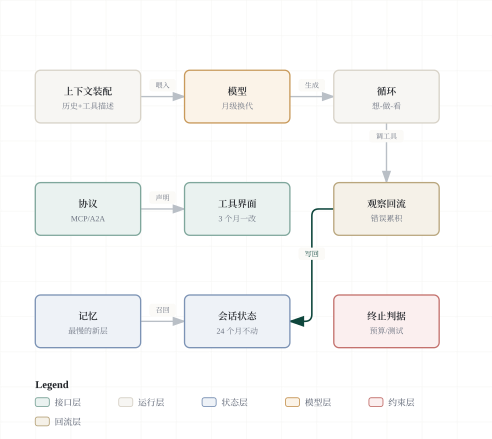
四代 harness,一条回路:我拆完八个框架后才看清的那张表
架构手记我从 ReAct 一路拆到 MCP,拆了八个框架、跑了十几个消融之后才发现:四代 harness 换的是同一张图里的两处接线。横轴是时间(四代),纵轴是五层(模型、上下文、循环、工具界面、状态)。这张表能回答三个问题:每一代换了哪层、为什么恰好是那时候、我自己这套现在该动哪一层。
0次浏览0条评论0个赞
邮件订阅:填个邮箱,我审核通过后就给你推送新文章,随时一键退订。(已在用 RSS 阅读器的话,下面有零注册入口。)
零注册、即时生效,适合已经在用阅读器的人:https://xiciyang.com/feed.xml
31 篇工程记录:AI 基础设施、Agent 系统、领域设计上的判断与取舍,以及把「什么叫成功」写成可验收判据的方法。
共 31 篇,按时间倒序。
我从 ReAct 一路拆到 MCP,拆了八个框架、跑了十几个消融之后才发现:四代 harness 换的是同一张图里的两处接线。横轴是时间(四代),纵轴是五层(模型、上下文、循环、工具界面、状态)。这张表能回答三个问题:每一代换了哪层、为什么恰好是那时候、我自己这套现在该动哪一层。
0次浏览0条评论0个赞
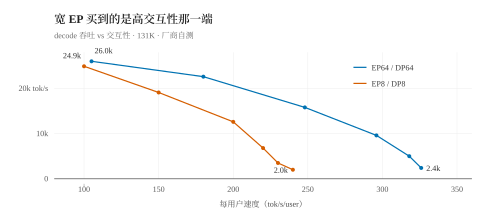
2026-10-20 DeepSeek 开源了内部推理框架 DeepInfer。它承认自己最初主要基于 vLLM 构建,只支持 V4.1-Flash、只跑 SM100 与昇腾 950,发布包里不含 KV 存储、PD 分离和负载均衡。把官方 README、部署 Q&A 和 benchmark 图逐条对到 vLLM / SGLang / TensorRT-LLM 的机制上,能看清垂直整合真正买到的三样东西:高交互性一侧的吞吐、用 140 个 token 换掉整段 prefill 重放、以及只值 4–7% 的置信度调度。所有吞吐数字都是厂商自测,文中逐条标注口径与失效区间。
0次浏览0条评论0个赞
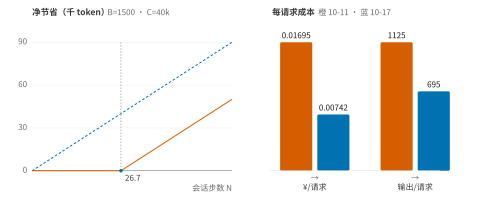
上一轮我把 700 个工具里的低频部分折叠进按需组,省了 95%。这一次我照着自己的结论继续折叠视觉、密码库这类中频工具,结果省下的还不够开一次组——每一步都要多付一整份上下文。返工之后留下的不是"别折叠",而是一道能算的算术:N·B > C。顺带我把这台机器的账单重新量了一遍:按请求算它便宜了 56%,但会话第 401 步之后每一步贵了 69%——后一个数字才是下一刀应该落的地方。
0次浏览0条评论0个赞
同一个能力做成插件和做成 CLI,代价差在每一步:插件的工具声明每次请求都在场,CLI 只在被调用时存在。按「谁决定调用时机、多久用一次、失败会污染谁」三个问题,把能力分到工具、Skill、MCP、套件、领域包与脚本六种形态,并给出动手前的三条验收。
0次浏览0条评论0个赞
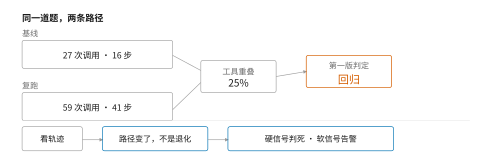
我给这台 agent 的改动加过很多能力,却只有一个六道合成题的行为闸门。真正的问题在落地五件测量工具那天暴露:重放闸门把四道真实任务里的两道判成回归,查下去发现坏的是判据,不是系统。这篇写这五件工具各自回答什么问题、什么时候触发、以及每件证明不了什么。
0次浏览0条评论0个赞
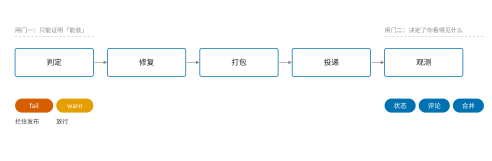
我用一天把四个自研包推成了公开仓库与七条收录 PR,结果是零合并。真正留下来的不是这七个链接,是中间那条产线:它把「合格」写成了能跑的判据,也暴露出一个盲区——监测器只盯 PR 状态、不盯评论,维护者的安全审查意见因此躺了两小时。这篇写产线怎么搭、闸门能证明什么、又在哪一刻彻底失效。
0次浏览0条评论0个赞
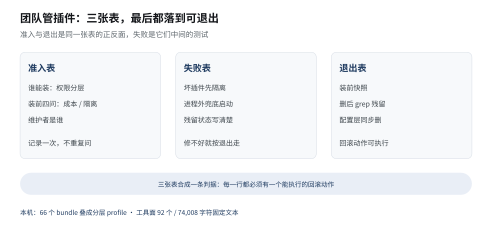
团队里第 3 个人装了一个插件,第 1 个人的会话行为跟着变了,却没人说得清是谁加的。团队治理的杠杆不在审批,而在退出路径:准入、失败、退出是三张表,衡量的是同一件事——每一行有没有一个能执行的回滚动作。
0次浏览0条评论0个赞
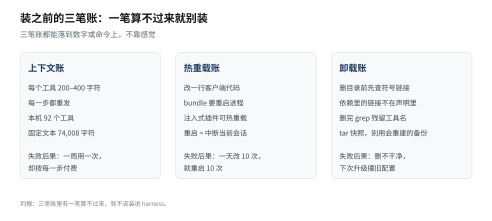
个人给自己加能力,装、写、接之间差的不是功能,而是三笔账:每个工具每步占多少上下文、改一次要不要重启、删掉要留多少尾巴。三笔账都能落到数字与命令上,有一笔算不过来,就不该装进 harness。
0次浏览0条评论0个赞
腾讯开源的 Hy-Memory 2.0 提供了完整的记忆分层与写入模型。评估后我们没有换栈:12 条真实查询的体检显示,覆盖率 8/12,向量召回 2/8,全文检索 7/8,瓶颈在检索通道与写入边界。
0次浏览0条评论0个赞
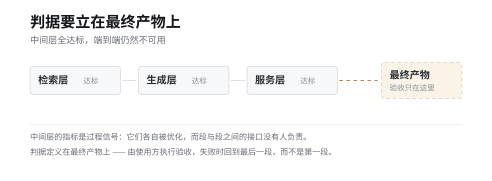
链路中间的指标会骗人:它们可以全部达标而最终产物不可用。说明为什么判据要定义在最终产物上,中间指标只能当过程信号,并给出把"最终产物判据"写出来的四步方法与三条常见反例。
0次浏览0条评论0个赞
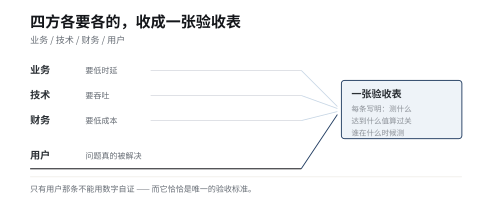
一个真实的运营商项目里,四方诉求互相拉扯:业务要低时延、技术要吞吐、财务要低成本、用户只关心问题有没有被解决。复盘我如何把四方诉求收成一张验收表、如何在没有管理权的情况下推动对齐,以及最后四条判据分别怎么落地。
0次浏览0条评论0个赞
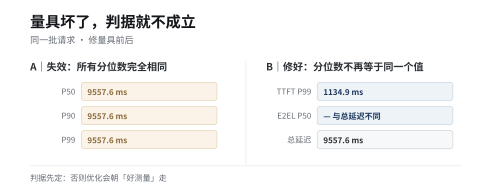
优化的前提是先有可信的度量——否则你不知道自己改善了什么,也不知道判据是否成立。从"量具坏了"这一类事故里总结出来的检查清单:怎么验证一个指标可信,怎么在优化前先固定判据。
0次浏览0条评论0个赞
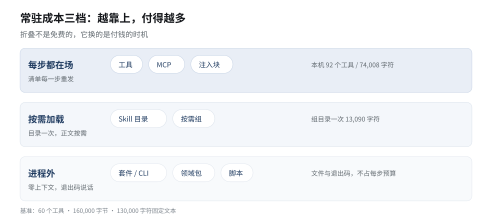
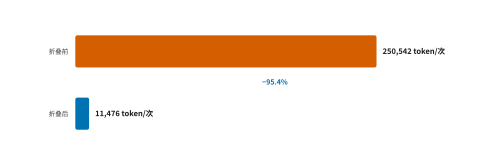
一次普通对话花掉 4900 万 token,根因不是模型,而是每次调用都要重发一遍的 25 万 token 固定前缀。我用会话日志里的原始字节把它压到 11,476 token/次(−95.4%),随后发现更大的持续浪费是打断前缀缓存(实测多付约 350 万 token 当量)与闲置的免费算力(利用率 0.1%)。文末列出六个我实测否决的主流方案,以及我拒绝做的三件事。**2026-10-17 补记第 12 节**:折叠之后账单换了形状——按全部固定文本口径实测 29,031 token/请求(11.3k 的声明在 PTC 模式下搬进了系统提示),并补上折叠回本判据 N·B > C 与一条「空转注入」的事故复盘。
0次浏览0条评论0个赞
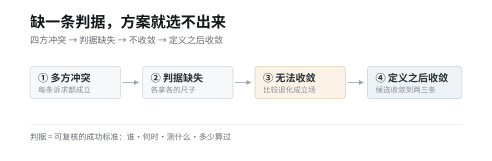
三方各有各的成功定义,方案就一定收敛不了——不是模型不行,是没人先把"什么叫成功"写成同一句话。失败链条拆成四步:多方冲突 → 判据缺失 → 方案无法收敛 → 定义统一判据后如何收敛,并给出可复用的定义流程。
0次浏览0条评论0个赞
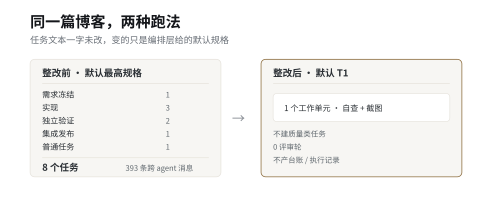
一篇博客被编排层拆成 8 个任务、产生 393 条跨 agent 消息。问题不在哪条门禁坏了,而在编排层根本没有「级别」这一维,于是最高规格成了默认值。复盘我怎么加上这一维、把「只能更轻」变成机器不变量,以及我为这个改动亲手造出、又被独立复核对出来的一个危险 bug。
0次浏览0条评论0个赞
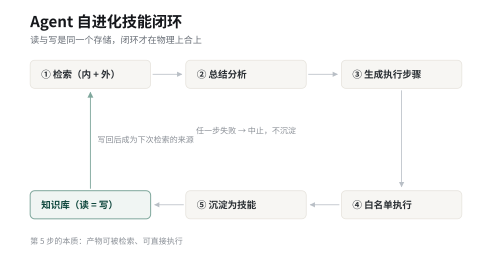
让 agent 自己长技能,真正的风险在于它把错的做法记成经验:技能库同时是它自己的判据来源,错一次会被记住很多次。我把它做通了(检索→计划→白名单执行→成功后蒸馏成技能写回同一个知识库),但通读代码后找到三处设计缺陷:白名单把解释器放了进去、自动沉淀默认开启、参数替换发生在分词之前。
0次浏览0条评论0个赞
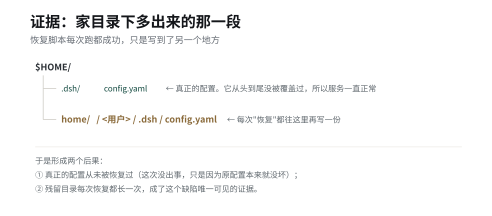
恢复机制存在了 9 天,日志显示它工作正常——但它一次都没真正生效过。根因是打包用相对路径、解压用 -C $HOME 的不匹配,产物是一段不该存在的 ~/home 目录。复盘这个静默失败,以及改完之后的 known-good 检查点与级联恢复设计。
0次浏览0条评论0个赞
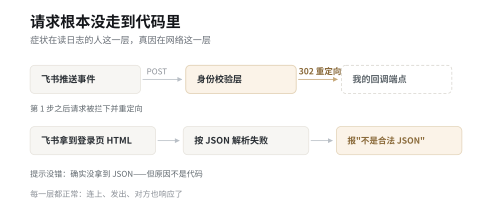
飞书回调配置全对、机器人一句话不回;浏览器镜像 HTTP 200、观察者计数正常、一帧都不出。两次都栽在同一件事上——把"接通了"当成"能用了"。用两条真实接入路径,把"约束在哪里""你看的是哪一份会话""什么才算成功"拆成三件可以独立回答的事。
0次浏览0条评论0个赞
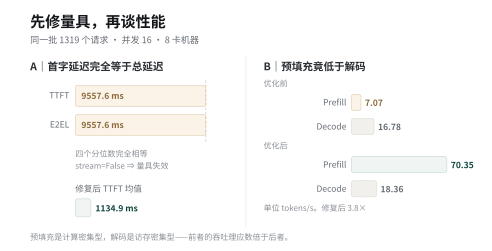
一份"看起来很完整"的性能报告里,TTFT 的每一个分位数都和总延迟一模一样——量具坏了。修好量具之后,第二个破绽暴露出来:Prefill 吞吐比 Decode 还慢,而这是物理上不该发生的。复盘这两次诊断与修复的实测数据,并说明我为什么把调优这件事从"多跑几轮看稳不稳"重写成了一台带失败路径的状态机。
0次浏览0条评论0个赞
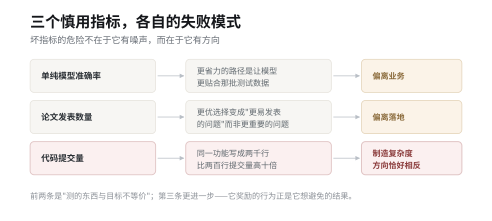
一个指标只要能被主动生产,它就会被生产。而 AI 岗位的关键能力恰好全都难以测量——于是人会用"容易测的量"替代,结果往往适得其反:"代码提交量"度量的是复杂度增长,激励方向与目标恰好相反。给出三个慎用指标及其失败模式、以行为锚定替代打分的做法,以及为什么岗位定义本身也有半衰期。
0次浏览0条评论0个赞
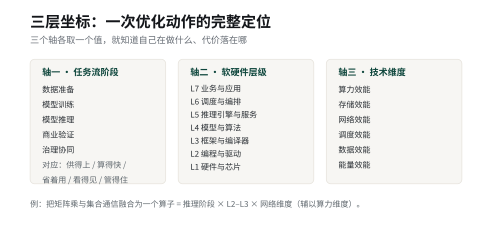
一份优化技术清单没有用,坐标系才有用。一套三层坐标(任务流阶段 × 软硬件层级 L1–L7 × 技术维度),三个带阈值的判墙判据,并用一个完整推导说明为什么坐标重要——GQA 模型的 KV 头数会决定张量并行是否在白白复制 KV Cache,以及该如何切回来。
0次浏览0条评论0个赞
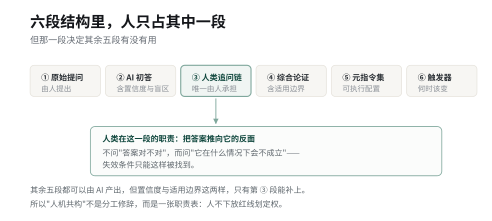
一次 AI 对话要变成可复用的资产,需要三件它通常不产出的东西——置信度、适用边界、可执行形式。一套六段式对话结构(原始提问 → 初答 → 人类追问链 → 综合论证 → 元指令集 → 自进化触发器)、追问链该推的三类问题,以及为什么最终形态必须是配置而不是散文。
0次浏览0条评论0个赞
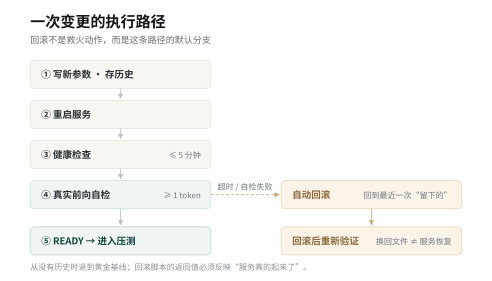
现场调参最贵的失败不是"参数调错了",而是"调崩之后回不去"。所以执行框架的设计目标是让每一次变更都可回滚、可验证、可审计;优化更快只是副产品。把"回滚永远可达"拆成六件可以写成脚本的事,并给出启动后五步验证、故障关键字速查与算子级杠杆的落点。
0次浏览0条评论0个赞
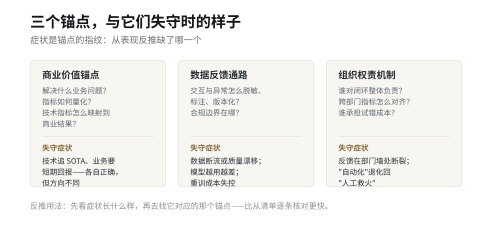
一个自动化闭环最容易被漏掉的部分不是流程本身,而是"谁来验收、拿什么验收、不通过怎么办"。复盘两个真实系统的设计:三位一体对齐与不做清单,以及一套把"还行"变成数字的评分卡、五层监督与自动卡点——并给出一个关键判据:规则与机制的差别,在于有没有卡点。
0次浏览0条评论0个赞
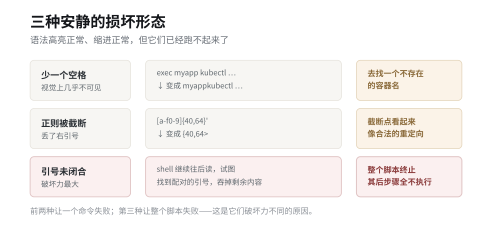
一段脚本只要没被真的执行过,它就只是文本——而文本会以非常安静的方式损坏:粘贴时丢一个空格、换行处截断一个字符、正则少一个右括号。用一个真实案例给出三关判据(能解析、能重复执行、失败可回滚),以及两处容易被忽略的部署约束。
0次浏览0条评论0个赞
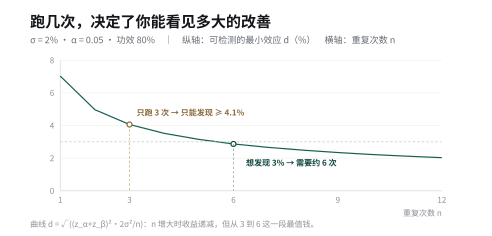
性能调优里最容易被跳过的一步,是回答"这次判定凭什么成立"。当测量噪声 σ≈2% 而你要判定的效应只有 3% 时,信噪比接近 1——"多跑几轮看稳不稳"在统计上是没有内容的。这件事可以拆成四层错误:固定阈值、样本量不足、边看边停、多指标齐看,并给出对应的四件工具(本机标定的动态阈值、功效分析、always-valid 推断、FDR 控制)。
0次浏览0条评论0个赞
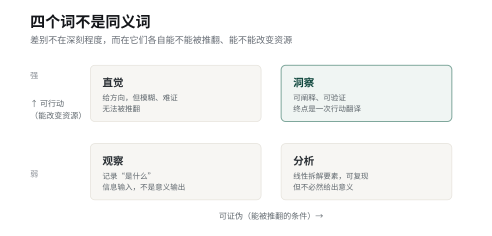
有些判断听起来很像洞察,甚至能被数据支持,却无法指导任何动作——它们是把相关当因果的伪洞察。一套可复核的检验:三条判据(机制穿透性、可验证性、范式价值)、一条从噪声到结论的 SOP、五层递进的能力台阶,以及用技术/业务/资本三个视角对同一个判断做压力测试的方法。
0次浏览0条评论0个赞
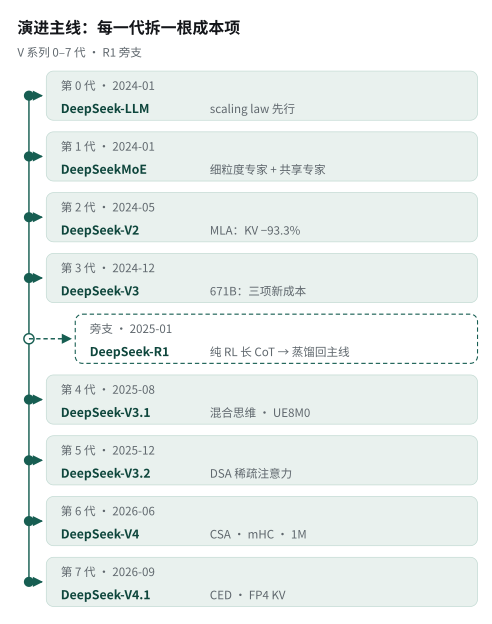
从 2024 年 1 月的 DeepSeek-LLM 到 2026 年 10 月的 DeepSeek-V4.1-Flash-1017,DeepSeek 近三年换了五种结构,却始终守着同一道判断标准——省资源,但不掉点。前九次发布每次都要在这条判据上做一次交换;2026-10-17 的第十次更新第一次没换结构,让基准普涨、运行时间与输出长度同时缩短。按「每一代拆掉哪一根成本项」把主线串起来,数字均标注论文或官方模型卡出处,折算与推算的账本在文末「口径与边界」。
0次浏览0条评论0个赞
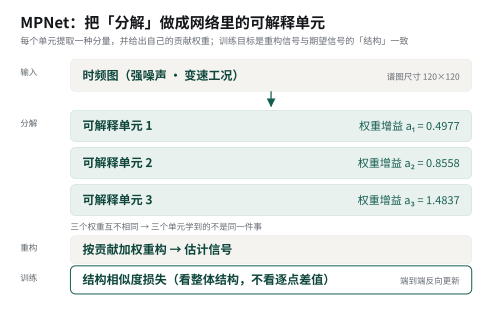
变速、强噪声下,故障时频图容易糊或脊线断裂。讲我为什么把「分解」做成网络里的可解释单元,以及它换来了什么样的可核结果。
0次浏览0条评论0个赞
没有同时满足这些条件的文章。