折叠不是免费的:一次「能藏就藏」的返工,和它换来的那条不等式
0次浏览0条评论0个赞
导语
照着上一篇《把 Agent 的每次调用砍掉 95%》的结论往下折中频工具,我买了张亏票:开一次组要付掉一整步上下文。核心是一条能当场算的不等式:N·B > C。
上一轮把常驻的工具说明书搬进按需目录,工具块从 250,542 token/次降到 11,476 token/次。这一轮我把视觉、密码库这类”中频”工具也折了进去,结果这笔账是亏的。原因很简单:开一次按需组要多走一步,而这一步的输入装着此前全部历史。折叠用「一次性付掉的 C」换「每步省下的 B」,划不划算取决于会话还剩多少步。
照着上一篇的结论往下折,26.7 步的门槛下面全是亏账
一句话:折叠的工具省的是每步的 B,付的是一次性的 C,只有会话步数 N > C/B 才回本。按本机实测 B≈1.5k token、C≈40k token 算,N 要大于 26.7 步;中频工具折一次是亏的,常驻声明折一次是赚的,差别只在 B 的量级。
写给同行工程师:如果你也抄过”把工具藏起来”这条经验,这页给的是它的适用区间。后半段有两个问题要逐个回答:这笔代价怎么量、重算整个账单之后下一刀该落在哪。
代价来自三条命令给出的真实请求账
核心是这条不等式:折叠的工具省的是每步的 B,付的是一次性的 C,只有会话步数 N > C/B 才回本。 按本机实测 B≈1.5k token、C≈40k token 算,门槛是 26.7 步。
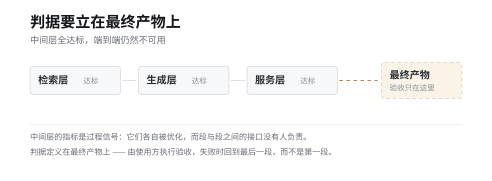
读法按三步走:先把代价量清楚(B、C,以及开组打断前缀缓存的额外折损);再看据此返工了什么(含 dsh-taskboard 整包移除);最后重算账单,回答下一刀该落在哪里。
这台机器的读数是真实请求账,不是估算[1]。价目是 2026-10-17 那一版:缓存命中 ¥0.02/M、未命中 ¥1.00/M、输出 ¥4.00/M——也就是 1 : 50 : 200。这个比例决定了后面每一个判断的方向:省 1 个输出 token,等于省 200 个缓存 token。
量具是两条命令,每次改完都重跑一遍(第 401 步那个数就是它给的):
node deploy-dsh/cost-tier-gate.mjs --strict   # 每请求¥ / 输出/请求 / 命中率 + 会话位置拐点
node deploy-dsh/tool-budget-gate.mjs          # 工具块字节 + 固定文本 + 缓存失效尖峰
最近的读数:当前会话工具块 43 个工具 / 39,033 字节(≈9,758 token),固定文本 62,379 字符(≈15,595 token/请求)。轮内注入累计 42,961 字符会被永久写进历史,其中工具组目录一项就占 10,895 字符——记住这个数,第三节要用。
图里左半边的两条线是同一件事的两种假设:虚线假设开组那次不打断前缀缓存,实线是实际发生的情况。两者只在第一个 C 的区间内分开,但分开的那一段就是”我以为省了、其实先亏了”的全部来源。
折叠的三笔账:先付 C,才轮到每步省 B
把「藏」写成三笔账,它就不再是一个直觉动作。
第一笔:B,每步省下的声明。 隐藏一块工具声明,省的是这块声明在每一次后续调用里的重复出现。实测一组中等规模的按需组(约 1.5k token),这就是 B。
第二笔:C,开一次组的代价。 机制在这里:每个请求的输入都是「固定前缀 + 到此为止的全部历史 + 本轮新内容」,模型没有”只追加一小段”的能力。开组要发一个新请求,它携带的历史与任何普通请求一样长。本机典型会话的上下文在 100k 以上,C 按这一整步的缓存档单价计,落在 40k token 量级,远大于 B。这就是错误的来源。
第三笔:缓存折损,也就是为什么 C 比看起来更贵。 工具声明位于前缀区。改动它,前面的前缀缓存全部作废,那一步的整段上下文按未命中价重算;按 1:50:200 的比例,缓存档的单价是未命中档的五十分之一。我的量具专门为这件事留了一个字段:
缓存失效尖峰:1 次 / 未缓存中位 733 ⇒ 多付约 13,849 token 当量 (尖峰多由 tool_list 开组 / 改指令文件 / 改 MCP 连接注入模式触发——它们会打断前缀缓存)
于是 C 实际不止一步:它包含被作废的整段前缀[2]。这也解释了为什么这条纪律的另一半写的是「会话开头一次性开齐工具组」——把开组和改指令文件都挤到会话边界,让折损只发生一次。
返工换掉的是判据:中频工具不该按”用得少”处理
返工的动作很小,判断却换了一整套:
| 我原来的做法 | 返工之后 | |
|---|---|---|
| 判据 | 这个工具用得少 → 藏起来 | 这个工具的声明 ≥ 1.5k token,且预计还要跑 >27 步 → 才藏 |
| 谁在付钱 | “藏起来的都是白赚” | 每次开组都付一整段上下文,且可能再付一次前缀作废 |
| 长会话怎么办 | 越长越藏 | 宁可让会话短,也不靠藏来压 |
后半句是这次返工真正的收获:如果压成本压的是”每步多大”,那么缩短会话和折叠工具是同一件事的两种做法——而缩短会话不用付 C[3]。
这一条还推得动别的事。我一度判定 dsh-taskboard”留着但别 hack 它”,理由是它在加载时注入约 2,100 字符协议、带 11 个常驻可见工具(≈10 KB/请求)。后来我按上面这套账重新判决:14 天里它只被用了 21 次,而它同时在做两件我现在都不想要的事——往每步注入文本、增加每步的工具声明。于是整包移除,数据仍留在 ~/.dsh/task-board/,装回是一条命令。
同一个逻辑也解释了 2026-10-18 那次精简里被清掉的其余四个包。dsh-univer-office:14 工具 + 8 skill + 213 MB,近 30 天 0 调用。dsh-ui-ux-pro-max:3 个可见工具 ≈640 token/请求,全期 1 次调用。@michengai/dsh-agency-agents:703 字符协议 + 6 工具,summon_expert 0 次。dsh-feishu:1 工具,最后调用停在 9 月 9 日。
两者都属”每步都在收费、而我只在极少数步里用到”,与功能好坏无关。
重账单:每请求便宜 56%,会话尾部却贵了 69%
上一轮结束时我写过”均价 0.063 vs 0.043 看着变贵,按请求算其实便宜了 56%“。这次我把这句话本身也当成一个待检验的断言。
| 日期 | 请求数 | 输出/请求 | 每请求 ¥ | 缓存命中 |
|---|---|---|---|---|
| 10-11 | 1,996 | 1,125 | ¥0.01695 | 99.24% |
| 10-17 | 2,963 | 695 | ¥0.00742 | 99.24% |
| 10-19 | 1,059 | 434 | ¥0.00805 | 97.70% |
同一把尺子下(每请求 ¥ 与输出/请求),10-17 比 10-11 便宜 56.2%,输出少 38.2%。10-11 是周日,全天低谷价,所以两组数不能拿来比”同一天是不是更便宜”;它们各自按未高峰价目算出,比的是同一把尺子下的口径。
但真正有用的是第三个数:会话位置拐点。
| 会话内位置 | 步数 | 上下文均 (k) | 每步 ¥ | 成本指数 |
|---|---|---|---|---|
| 第 1–25 步 | 3,983 | 113 | ¥0.01004 | 1.00× |
| 第 26–50 步 | 2,219 | 195 | ¥0.00917 | 0.91× |
| 第 51–100 步 | 3,523 | 256 | ¥0.01004 | 1.00× |
| 第 101–200 步 | 4,702 | 327 | ¥0.01252 | 1.25× |
| 第 201–400 步 | 4,055 | 431 | ¥0.01462 | 1.46× |
| 第 401+ 步 | 3,195 | 513 | ¥0.01699 | 1.69× |
会话过了第 401 步,单步成本是开局的 1.69 倍,此后每一步都在加价。把 10-17 的 2,963 次请求按每请求 ¥0.00742 结算,一天约 ¥21.99;10-11 的 1,996 次按 ¥0.01695 是 ¥33.83。这两个数就是”只认每请求 ¥“这条纪律的由来。
所以我现在的判断是:缓存档占了大头,但它的杠杆弱;输出和”会话别拖太长”才是两个能真正动手的旋钮。 折叠工具只影响每步的大小,会话有多长,决定了这个大小被相乘多少次。
推翻「能藏就藏」:中频工具每折一次要先亏 40k token
被这组数推翻的:
- “能藏就藏”。中频工具折一次要付 ≈40k token 的 C,而它每步只省 1.5k。
- 把
dsh-taskboard留在原地的那条判断(已整包移除)。 - “先折叠、再管会话长度”的顺序。反过来才对:先让会话短,再问剩下那些还要不要藏。
仍然成立的:
- 高频工具留在手上、低频进目录。这条只为信息卫生:看得见不等于用得到。
- 不把总 token 数当指标。它 99% 落在缓存档,量它只会量出缓存量的漂移。
- 每个”已修复”都要用闸门重测一遍再引用。返工的起点是用上一次的结论去指导下一次动作,中间没有重测。
反例:同一套折叠,B 有 6 位数时第一步就回本
这条不等式有一个明确的赚的区间。反例来自同一台机器上的另一个动作:隐藏一整块常驻声明,工具块从 250,542 降到 11,476 token/次,B 大约 60k token。按 N·B > C 算,N 只要大过 0.7 步就回本,当场赚。差别全在 B 的量级:一块声明有 6 位数 token,一个中频工具组的声明只有 4 位数。
判据因此可以写成两句话:B 与 C 同一量级时,看会话还剩多少步;B 远大于 C 时,无条件折。 我犯错的地方,是把第二句话的结论搬到了第一句话的场景里。
另一条边界:开组若发生在会话第一轮(历史还很短),C 就退化成”一步短请求”,门槛大幅下降。AGENTS.md 里那条”会话开头一次性开齐工具组”,正是站在这个退化点上。
口径与边界
- 所有数字来自单机、单人、单模型路由;B、C 都是本机实测值,换厂商的缓存语义与上下文规模后绝对值不可搬用,方法可以。
- C≈40k 是本机典型会话的上下文量级,不是精确常数;它在会话不同阶段的取值不同,我图里用的是一条保守的折线,目的是判方向,不是给结算。
N·B > C只算了开组那一步,没有把”前缀作废后整段重算”折算进去。把折损算进去,真实的回本步数比 26.7 更大——这不影响结论方向,但意味着那条不等式的门槛应该再抬高。- 这些数我只量了三天。
10-19的命中率 97.70% 已经跌破 99% 的目标,闸门判 FAIL——这一次没修,因为我把它当成下一次要处理的对象,留待下一轮。
参考文献
[1] 本机实测(可复现):DSH 会话日志里的真实请求 usage 记录。复现命令:node deploy-dsh/cost-tier-gate.mjs --strict、node deploy-dsh/tool-budget-gate.mjs。
[2] DeepSeek, Context Caching —— 前缀缓存的计价与失效语义:https://api-docs.deepseek.com/guides/kv_cache
[3] Anthropic, Managing context on the Claude Developer Platform —— 上下文编辑(清理过期工具结果)带来的 token 节省:https://www.anthropic.com/news/context-management
评论
填个昵称就能发,不需要注册或登录