判据必须定义在最终产物上在写
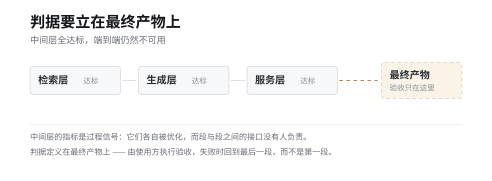
专业洞察链路中间的指标会骗人:它们可以全部达标而最终产物不可用。说明为什么判据要定义在最终产物上,中间指标只能当过程信号,并给出把"最终产物判据"写出来的四步方法与三条常见反例。
0次浏览0条评论0个赞
邮件订阅:填个邮箱,我审核通过后就给你推送新文章,随时一键退订。(已在用 RSS 阅读器的话,下面有零注册入口。)
零注册、即时生效,适合已经在用阅读器的人:https://xiciyang.com/feed.xml
先定"什么叫成",再选路线:判据怎么写成技术、业务、财务、用户四方都认的一张表,以及它在真实项目里成立与失效的边界。
链路中间的指标会骗人:它们可以全部达标而最终产物不可用。说明为什么判据要定义在最终产物上,中间指标只能当过程信号,并给出把"最终产物判据"写出来的四步方法与三条常见反例。
0次浏览0条评论0个赞
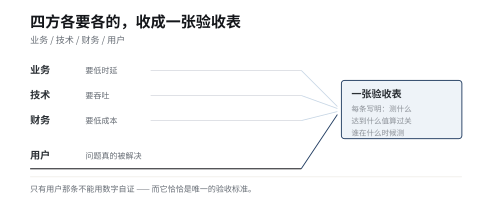
一个真实的运营商项目里,四方诉求互相拉扯:业务要低时延、技术要吞吐、财务要低成本、用户只关心问题有没有被解决。复盘我如何把四方诉求收成一张验收表、如何在没有管理权的情况下推动对齐,以及最后四条判据分别怎么落地。
0次浏览0条评论0个赞
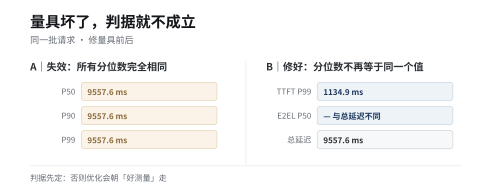
优化的前提是先有可信的度量——否则你不知道自己改善了什么,也不知道判据是否成立。从"量具坏了"这一类事故里总结出来的检查清单:怎么验证一个指标可信,怎么在优化前先固定判据。
0次浏览0条评论0个赞
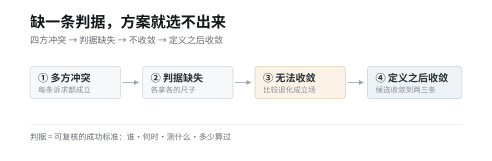
三方各有各的成功定义,方案就一定收敛不了——不是模型不行,是没人先把"什么叫成功"写成同一句话。失败链条拆成四步:多方冲突 → 判据缺失 → 方案无法收敛 → 定义统一判据后如何收敛,并给出可复用的定义流程。
0次浏览0条评论0个赞
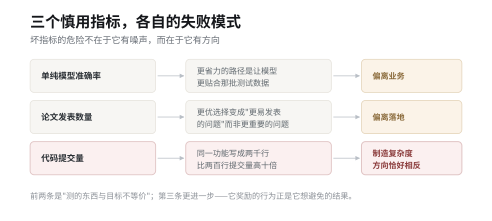
一个指标只要能被主动生产,它就会被生产。而 AI 岗位的关键能力恰好全都难以测量——于是人会用"容易测的量"替代,结果往往适得其反:"代码提交量"度量的是复杂度增长,激励方向与目标恰好相反。给出三个慎用指标及其失败模式、以行为锚定替代打分的做法,以及为什么岗位定义本身也有半衰期。
0次浏览0条评论0个赞
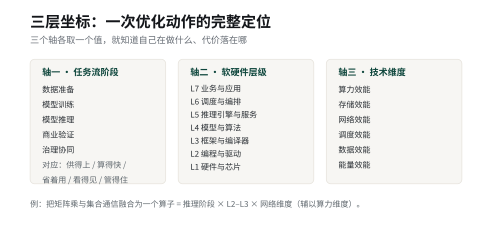
一份优化技术清单没有用,坐标系才有用。一套三层坐标(任务流阶段 × 软硬件层级 L1–L7 × 技术维度),三个带阈值的判墙判据,并用一个完整推导说明为什么坐标重要——GQA 模型的 KV 头数会决定张量并行是否在白白复制 KV Cache,以及该如何切回来。
0次浏览0条评论0个赞
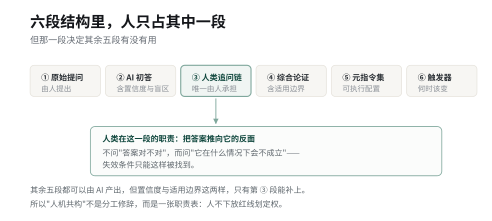
一次 AI 对话要变成可复用的资产,需要三件它通常不产出的东西——置信度、适用边界、可执行形式。一套六段式对话结构(原始提问 → 初答 → 人类追问链 → 综合论证 → 元指令集 → 自进化触发器)、追问链该推的三类问题,以及为什么最终形态必须是配置而不是散文。
0次浏览0条评论0个赞
一个自动化闭环最容易被漏掉的部分不是流程本身,而是"谁来验收、拿什么验收、不通过怎么办"。复盘两个真实系统的设计:三位一体对齐与不做清单,以及一套把"还行"变成数字的评分卡、五层监督与自动卡点——并给出一个关键判据:规则与机制的差别,在于有没有卡点。
0次浏览0条评论0个赞
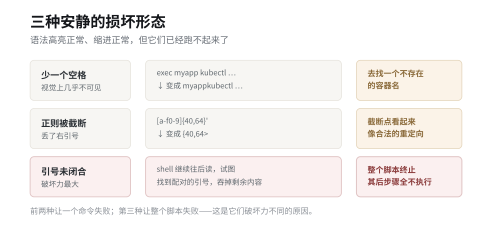
一段脚本只要没被真的执行过,它就只是文本——而文本会以非常安静的方式损坏:粘贴时丢一个空格、换行处截断一个字符、正则少一个右括号。用一个真实案例给出三关判据(能解析、能重复执行、失败可回滚),以及两处容易被忽略的部署约束。
0次浏览0条评论0个赞
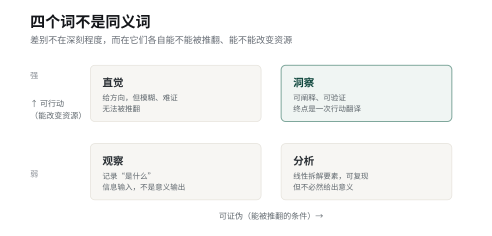
有些判断听起来很像洞察,甚至能被数据支持,却无法指导任何动作——它们是把相关当因果的伪洞察。一套可复核的检验:三条判据(机制穿透性、可验证性、范式价值)、一条从噪声到结论的 SOP、五层递进的能力台阶,以及用技术/业务/资本三个视角对同一个判断做压力测试的方法。
0次浏览0条评论0个赞