从三方冲突到四方对齐:一个运营商项目的判据定义过程
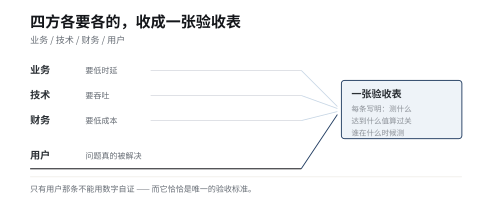
落地为证一个真实的运营商项目里,四方诉求互相拉扯:业务要低时延、技术要吞吐、财务要低成本、用户只关心问题有没有被解决。复盘我如何把四方诉求收成一张验收表、如何在没有管理权的情况下推动对齐,以及最后四条判据分别怎么落地。
0次浏览0条评论0个赞
邮件订阅:填个邮箱,我审核通过后就给你推送新文章,随时一键退订。(已在用 RSS 阅读器的话,下面有零注册入口。)
零注册、即时生效,适合已经在用阅读器的人:https://xiciyang.com/feed.xml
一个运营商项目里,三方各执一词到四方对齐;一台 8 卡机器上,先修量具再谈性能;一次调用成本从字节开始砍掉 95%。交付现场的共同点:判据先立,数字才成立。
一个真实的运营商项目里,四方诉求互相拉扯:业务要低时延、技术要吞吐、财务要低成本、用户只关心问题有没有被解决。复盘我如何把四方诉求收成一张验收表、如何在没有管理权的情况下推动对齐,以及最后四条判据分别怎么落地。
0次浏览0条评论0个赞
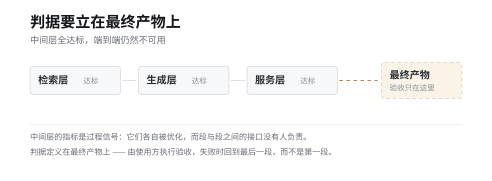
链路中间的指标会骗人:它们可以全部达标而最终产物不可用。说明为什么判据要定义在最终产物上,中间指标只能当过程信号,并给出把"最终产物判据"写出来的四步方法与三条常见反例。
0次浏览0条评论0个赞
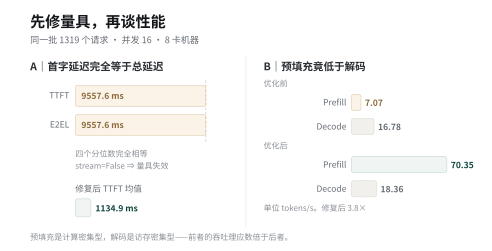
一份"看起来很完整"的性能报告里,TTFT 的每一个分位数都和总延迟一模一样——量具坏了。修好量具之后,第二个破绽暴露出来:Prefill 吞吐比 Decode 还慢,而这是物理上不该发生的。复盘这两次诊断与修复的实测数据,并说明我为什么把调优这件事从"多跑几轮看稳不稳"重写成了一台带失败路径的状态机。
0次浏览0条评论0个赞
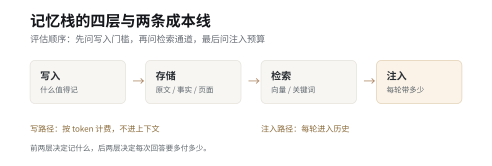
腾讯开源的 Hy-Memory 2.0 提供了完整的记忆分层与写入模型。评估后我们没有换栈:12 条真实查询的体检显示,覆盖率 8/12,向量召回 2/8,全文检索 7/8,瓶颈在检索通道与写入边界。
0次浏览0条评论0个赞
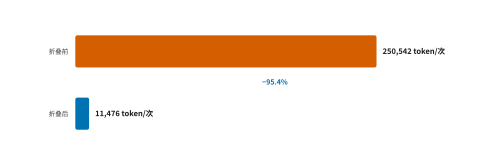
一次普通对话花掉 4900 万 token,根因不是模型,而是每次调用都要重发一遍的 25 万 token 固定前缀。我用会话日志里的原始字节把它压到 11,476 token/次(−95.4%),随后发现更大的持续浪费是打断前缀缓存(实测多付约 350 万 token 当量)与闲置的免费算力(利用率 0.1%)。文末列出六个我实测否决的主流方案,以及我拒绝做的三件事。**2026-10-17 补记第 12 节**:折叠之后账单换了形状——按全部固定文本口径实测 29,031 token/请求(11.3k 的声明在 PTC 模式下搬进了系统提示),并补上折叠回本判据 N·B > C 与一条「空转注入」的事故复盘。
0次浏览0条评论0个赞
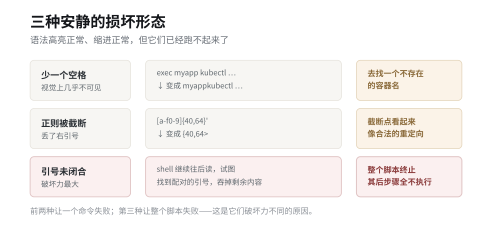
一段脚本只要没被真的执行过,它就只是文本——而文本会以非常安静的方式损坏:粘贴时丢一个空格、换行处截断一个字符、正则少一个右括号。用一个真实案例给出三关判据(能解析、能重复执行、失败可回滚),以及两处容易被忽略的部署约束。
0次浏览0条评论0个赞