先修量具,再谈性能:一次 8 卡推理调优复盘,和一套带失败路径的调优状态机
0次浏览0条评论0个赞
那份压测报告看上去毫无问题:有吞吐、有时延、有分位数、有长尾。
但我盯住的那个数却露了馅——TTFT 的每一个分位数,都和总延迟一模一样(平均都是 9557.6 ms)。
大多数人会把它当成”时延偏低”的好消息。这个字段整体失效了:压测没有开流式输出。
性能调优里最贵的一类错误,是把一个坏掉的量具当成可信输入。参数调错,你会在错误的方向上多花几天;量具坏掉,你会在一个根本不存在的世界里得出所有结论,而且每一个结论看起来都有数据支撑。
一、一份”看起来很完整”的报告,其实量具是坏的
先说第一次诊断。它发生在一份看上去无懈可击的报告里。
这份报告确实很完整:有吞吐、有时延、有分位数、有长尾,格式挑不出问题。
测试条件是:
- 总请求数 1319,并发稳定在 16
- 平均输入 62.95 tokens,平均输出 158.54 tokens
报告给出的关键指标里,有一条让我停下来:
TTFT 的平均值、最小值、P99 等所有分位数,都和 E2EL 一模一样——平均都是 9557.6 ms。
TTFT(Time To First Token,首字延迟)和 E2EL(End-to-End Latency,端到端延迟)是两个不同的量。前者是”用户等多久看到第一个字”,后者是”用户等多久拿到完整回答”。它们只有在一种情况下会相等:回答只有一个 token。
而这份报告里平均输出是 158.54 个 token。
所以真正发生的事情是:压测没有开流式输出(stream=False)。在非流式模式下,客户端会一直等到模型把 158 个 token 全部生成完,才开始计时并返回——此刻”首字时间”在物理上就等于”总时间”。
这跟精度无关:这个字段整体失效。那份报告里所有关于 TTFT 的分位数、长尾、P99,讨论的都是别的东西。
我在这里学到的判据很简单,可以背下来:
当 TTFT 的每个分位数都等于 E2EL 时,你测到的是总延迟,不是首字延迟。
这不是”数据看起来有点怪”,这是一个恒等式:只要 流式=false,TTFT ≡ E2EL 就必然成立,与模型、硬件、负载全都无关。所以它不需要经验阈值来判断——它是一个定义上的矛盾。
为什么这个错误值得单独拿出来讲
因为它不报错。服务正常启动,请求正常返回,报告正常生成,指标正常填充,每一个数字都是真的。唯一的问题是这些数字回答的不是你想问的问题。
如果我没有盯住”TTFT 为什么不等于它自己”,这份报告会一路走到客户面前,而我们会围绕一组失效数据进行一整轮”优化”。
二、Prefill 比 Decode 还慢:用物理不变量判异常
上一节修的是量具。但那份报告里还藏着第二个破绽,而且它更隐蔽——因为数字本身”看起来正常”。这次它不那么显眼,因为数字本身”看起来正常”:
| 指标 | 数值 |
|---|---|
| 单请求生成速度(OutputTokenThroughput) | 平均 16.78 tokens/s |
| Prefill 吞吐量(PrefillTokenThroughput) | 平均 7.07 tokens/s |
单看每一个数字都不刺眼。但把它们放在一起,就违反了一条物理不变量:
Prefill 是计算密集型,Decode 是访存密集型。前者的吞吐理应显著高于后者——通常高出 5 到 10 倍。
而这里是 7.07 对 16.78:预填充比解码还慢了一半。
这不是”慢”,这是”方向不对”。在一个 transformer 推理服务里,如果 prefill 比 decode 慢,那么无论你怎么调 max_num_seqs、怎么调并发、怎么调显存水位,你优化的是两个已经不成立的前提之下的组合。
我当时列了三个可能原因:
- 调度策略把 prefill 和 decode 混在同一个 batch 里,prefill 被 decode 拖累;
- 算子未针对短输入优化——平均输入只有 63 个 token,属于典型的短 prompt 场景,在 NPU 上对短序列的 prefill 处理效率可能很低;
- 分块预填充(Chunked Prefill)未开启,长 prompt 阻塞了后续请求。
注意这个推理顺序:先立不变量,再看违反,最后才猜原因。如果我反过来,先看”7.07 这个数是不是比上次低”,我只会得到”这次有点慢”——而它属于”错”,不属于”慢”。
三、修复:先把量具修好,再动参数
前面两节是”发现问题”,这一节是”怎么修”。我采用的顺序是刻意的:
第一步,修测试配置。在压测请求里打开 stream: True。这一步不改变服务端任何东西,它只是让 TTFT 这个字段重新有意义。在量具修好之前,任何性能结论都不成立,所以这一步必须排在最前面——哪怕它”不提升性能”。
第二步,开启 Chunked Prefill。在 vLLM 启动参数里加上 --enable-chunked-prefill [1],把长 prompt 的计算打散,避免它阻塞解码过程。
第三步,暂缓并发与显存参数。报告里当时建议把并发从 16 提到 24 或 32——KV Cache 只分配了 10.14 GiB,而可用余量还有约 18.5 GiB,确实还有空间。但我没有动它。理由:在 prefill 路径还是异常的情况下,提高并发只会把异常放大到更多请求上。先让每个请求走在正确的路上,再谈同时走多少个。
这一步是整篇文章里我最想让人记住的取舍:“还有余量”不等于”现在就该用掉它”。
四、结果:TTFT 降 88%,Prefill 涨 895%
修完之后,回到同一批请求重跑。同样的并发(16)、同样的请求量(1319),优化前后的对比:
首字延迟
| 指标 | 优化前 | 优化后 | 变化 |
|---|---|---|---|
| 平均 TTFT | 9557.6 ms | 1134.9 ms | ⬇️ 88.1% |
| P99 TTFT | 20659.0 ms | 7343.3 ms | ⬇️ 64.5% |
预填充吞吐
| 指标 | 优化前 | 优化后 | 变化 |
|---|---|---|---|
| 平均 Prefill 吞吐 | 7.07 token/s | 70.35 token/s | ⬆️ 895% |
| P90 Prefill 吞吐 | 10.27 token/s | 117.10 token/s | ⬆️ 1040% |
这里有一个必须讲清楚的地方:TTFT 那 88% 里,有多大比例是”真的变快了”,有多大比例是”量具修好了”?
诚实的回答是:这两者在这个实验里是缠在一起的,不能分开。优化前的 TTFT 数据本身就是失效的——它不是”响应慢”,它是”总延迟被叫做首字延迟”。所以 88.1% 这个数字的准确含义是”从一份把总延迟当首字延迟的报告,变成了一份真的在测首字延迟的报告”,而不是”首字响应速度提升了 88%”。
真正可以干净归因的是 Prefill 那一组:+895%。这一组的分母和分子是同一个量在同一个定义下的两次测量,所以它是可比的。它也确实是这次修复的技术核心——prefill 从 7.07 涨到 70.35,变成 decode(18.36)的约 3.8 倍,重新回到”prefill 快于 decode”的正常区间。
关于 Chunked Prefill 是否”已生效”,我只能说它很可能生效了:prefill 与 decode 的相对关系恢复正常是它的典型特征。我没有做单独的开关对照实验,所以这里不宣称因果已闭环。
单请求与系统级吞吐
| 指标 | 优化前 | 优化后 | 变化 |
|---|---|---|---|
| 单请求生成速度 | 16.78 token/s | 18.36 token/s | ⬆️ 9.4% |
| 输出 Token 吞吐(系统级) | 264.74 token/s | 281.25 token/s | ⬆️ 6.2% |
| 总 Token 吞吐 | 369.86 token/s | 392.10 token/s | ⬆️ 6.0% |
| 请求吞吐 | 1.67 req/s | 1.76 req/s | ⬆️ 5.4% |
端到端时延从 9.56 秒降到 8.96 秒。这个幅度(约 6%)和系统吞吐的提升幅度(约 6%)是一致的——在同一批请求上,吞吐提升多少,平均端到端时延就大致下降多少,这是一条可以用来互相校验的自洽关系。如果两者对不上,说明中间有测量或口径问题。
五、“多跑几轮看稳不稳”为什么不够
前四节讲的都是这一次诊断。接下来要说的是它顺手翻出来的另一个问题。
修完这一次之后,我回头看自己原来那套调优方法。它的核心是三条规则:
- 先分级,再深入;
- 分阶段看本质(prefill 计算密集、decode 访存密集);
- 改一点,验一次。
这三条都对,但它有一个我不知道怎么处理的漏洞:“验一次”里的”验”,标准是什么?
我原来的做法是”多跑几轮,看稳不稳,然后阈值拍 3%“。这套做法有三重根因,而且是结构性的,不是执行得不到位:
第一重,组合爆炸。可调参数是一张网格,不是一张列表——内存与并发、调度、特性开关、分布式并行、系统级环境变量,五层里每一层都有若干连续或枚举维度。五个维度上做”每次调一个参数、做局部爬坡”,在不合理的轮数预算内基本覆盖不到有意义的区域。你最后得到的是爬坡路径的终点,不是最优点。
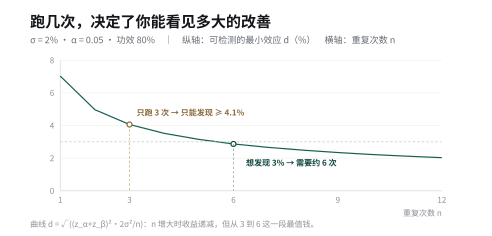
第二重,噪声。这类机器的测量标准差通常在 2% 上下,而我要判定的效应量也在 3% 这个量级——信噪比接近 1。在这种情况下,“这一轮 3.5%,比上一轮 3.1% 好,所以接受”这句话在统计上是没有内容的:3.5% 和 3.1% 的差别比噪声还小。我把阈值固定成 3%,等于假设噪声是常数,而它不是。
第三重,非平稳。服务不是一台稳定的仪器:显存碎片、散热与功耗状态、邻居负载、缓存命中率,都会随时间漂移。一条”三小时前测的基线”和”现在测的结果”做对比,比的可能是时间,不是参数。
所以问题不在”我够不够勤”,而在这套流程没有定义”什么叫做一次有效的判定”。
贯穿线:调优的难点不在参数,而在”判定是否成立”
前面五节拼起来是一条完整的逻辑链:量具可能坏(一)→ 物理不变量可以被违反(二)→ 修复必须先于调参(三、四)→ 而”多跑几轮看稳不稳”这套判定方法,在组合爆炸、噪声与非平稳下必然不成立(五)。
它们指向同一个结论:
在调优里,你几乎没有一次失败是因为”不知道调哪个参数”,而总是因为”没发现自己的判定不成立”。
这也决定了后半部分的形状。它要的是让每一次判定站得住的基础设施,不是更多调参技巧:先给流程加一层数据校验(状态机里的 VALIDATE),再给阈值加一层统计依据(第七节),最后才谈搜索与参数(第八节)。换句话说,顺序错了,前面每一步做得越认真,离正确越远。
六、把调优写成一台状态机
上一节指出了原方法的失效条件,这一节把它换成一台状态机。
重写的第一步是改掉目标。原来我追求”调出最优配置”,现在我承认:
严格的全局最优在工程上不可达。三重根因——组合爆炸、测量噪声、非平稳——决定了这个目标无法被验证,而一个无法被验证的目标等于没有目标。
所以目标被重新定义为三件事:在给定预算内逼近 Pareto 前沿、持续跟踪、统计上稳健。对外只说”预算内的近全局最优”,不说”全局最优”。
改掉目标之后,流程就能写成状态机了。关键是每个状态都必须写出失败路径,而不在于”有哪些状态”——这是我原来那套流程完全没有的东西:
| 状态 | 入口触发 | 守卫 | 出口 | 失败路径 |
|---|---|---|---|---|
| IDLE | 启动指令 | 环境清单校验通过 | BASELINE | 校验失败 → 停机并报告缺项 |
| BASELINE | 基线采集 | 压测工具与驱动健康 | VALIDATE | 压测失败 → 重试 ×2 → 终止 |
| VALIDATE | 采集完成 | 校验规则 | ANALYZE | 不通过 → 重采(≤3 次) |
| ANALYZE | 结构化数据 | 分析器可用 | DECIDE | 不可用 → 确定性兜底 |
| DECIDE | 分析完成 | 预算 > 0 且未饱和 | APPLY | 预算耗尽 → 收敛 |
| APPLY | 单条变更(含耦合对) | 空跑通过 + 拿到并发锁 | VERIFY | 启动失败 → 回滚至当前最优;连续 2 次 → 标记环境异常 |
| VERIFY | 新一轮压测 | N 次重复测量 + 检验通过 | GATE | 压测异常 → 再测 1 次 → 仍异常 → 回滚 |
| GATE | 统计计算完成 | 决策表 | 接受 → ANALYZE / 拒绝 → ANALYZE | — |
| CONVERGED | 终止条件 | — | DELIVER | — |
| DELIVER | 报告生成 | — | 上线后监测 / 结束 | — |
| POST-DEPLOY | 在线监测 | 漂移触发 | IDLE(新一轮) | — |
这张表里三处是原来没有的:
APPLY的失败路径:任何变更必须先保留”当前最优”以便一键回滚;启动失败或健康检查超时,自动回滚;连续两次启动失败就收敛并标记环境异常——不要继续试。承认”现在这台机器的状态不对”,停下来比继续更有价值。VERIFY的守卫:要求完成 N 次重复测量且检验通过,不接受”跑一次看看”。守卫不满足就不许进 GATE。VALIDATE这个状态本身:它专门用来在分析之前检查数据是否有效。第一节那个 TTFT ≡ E2EL 的案例,就是被这个状态拦下来的。如果我原来的流程里有 VALIDATE,那份报告根本走不到分析阶段。
此外,同一服务同一时刻只允许一个调优运行(租约 + 锁文件 + 超时防死锁),生产变更保留人工确认环节,离线沙箱可以免除。这些不是流程装饰,它们防的是”两个调优进程互相把对方的改动当成自己的结果”这种事故。
七、阈值不该拍脑袋:t = max(2σ, 3%)
前面那台状态机里,有一处我故意留到最后讲:闸门上”接受”的门槛,是从哪来的。
这是我认为整套方法论里最不可替代的一段。
接受阈值不能再固定成 3%,因为噪声不是常数。改成:
t = max(2 × σ_baseline, 3%)其中 σ_baseline 是在当前机器上实测出来的基线标准差,不是产品手册上的数字。含义很直白:接受一个变更,至少要求它的改善量达到基线噪声的两倍;同时保留 3% 的下限,避免在一台特别安静的机器上把门槛降到没有意义。
再往后,三件事必须配套上,否则”统计显著”仍然是个口号:
一是功效分析,先算样本量再开跑 [2]。要判定的效应量是 d,噪声是 σ,那么所需重复次数大致是:
n ≈ (z_α + z_β)² · 2σ² / d²意义是:如果你只有时间跑 3 次,而你需要的样本量是 8,那么”跑了 3 次没看出差别”不构成”没有差别”的证据。原来我把”多跑几轮”当成谨慎,其实那只是把结论建立在样本量不足之上。
二是序贯测试要控总体错误率 [3]。调优是边看边停的——看到好结果就想停,这本身就是多重比较。用 always-valid 的推断(置信序列一类的构造)替代固定样本的检验,才能在”随时可以停下来”的前提下仍然控制第一类错误。
三是多个指标一起判时要控 FDR [4]。吞吐、TTFT、TPOT、P99、显存水位——同时看五个指标,“至少一个显著”的概率天然被放大。用 Benjamini-Hochberg 这类方法控错误发现率,而不是对每个指标各判各的。
漂移检测同理,从”规则式告警”升级成算法:CUSUM、Page-Hinkley、ADWIN、贝叶斯在线变点检测 [5]——它们的共同点是能回答”变化发生在哪一刻”,而不只是”现在和过去不一样”。
八、从”调参”到”搜索”
因此,有了判定协议之后,“每次调一个参数往上爬”就可以被替换成真正的搜索:
- 冷启动用 Latin Hypercube 或 Sobol 序列铺点,而不是随机撒点——它保证初始样本在每一维上的分布是均匀的,这在五维空间里差别很大;
- 代理模型用高斯过程拟合”参数 → 指标”的响应面;
- 采集函数用 EI / UCB 决定下一个点测哪里,多目标用 qEHVI / qNEHVI;
- 早停用 Hyperband / BOHB 砍掉明显没希望的区域;
- 并且保留一个工程细节:每 5 轮注入 1 个纯随机点——防止代理模型把自己困在局部最优里自说自话。
收敛之后交付 3 到 5 个 Pareto 解 + 占优率 + 自动识别出的 knee point(最大边际效用法或超体积梯度法),再加一个业务推荐点。
这个改动的意义是:把”调参结果”从一个点变成一条前沿。一台机器上”吞吐最高”和”延迟最低”通常是两个不同的配置,而原来那套流程只会给你其中随机一个。
还有一条我觉得很重要的工程自觉:AI 参与的决策必须可审计、可重放。决策日志结构化记录输入、输出、模型版本、prompt 哈希、延迟;推理时温度取 0 或固定随机种子;每一份”当前最优”配置都能反查”它是哪一条决策产生的那一次修改”。否则三个月后你面对一个配置,无法回答”它为什么长这样”。
九、让”回滚永远可达”变成脚本能证明的事
下面从方法论转到落地。方法论落到现场,最容易失效的地方是脚本,不是算法。而脚本里最容易被跳过的一步,是”失败了怎么办”。
所以这套东西的落地形态是一组脚本,其中三个的职责是明确的:
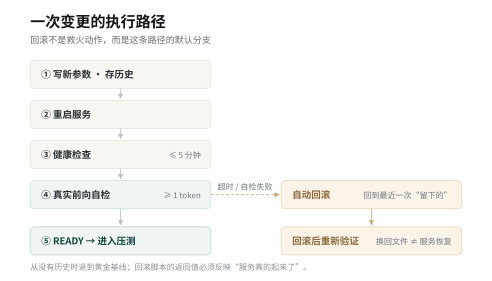
- 启动后验证:不只检查容器活着,而是依次验证——服务健康、模型名正确、真的跑一次前向推理拿到至少 1 个输出 token、指标端点出现预期前缀、加速器显存确实已加载权重。“进程在跑”和”服务能用”是两件事,这一串验证就是在把第二件事自动化。
- 重启脚本:带健康检查轮询 + 就绪探测 + 一次真实前向自检,超时自动调用回滚。也就是说,回滚不是一个”出事时记得手动执行”的步骤,它是重启流程的默认分支。
- 回滚脚本:回到最近一次”留下的”配置——注意是”留下的”,不是”上一次改的”。被拒绝的变更不应该成为回滚目标。
还有一条纪律值得单独写出来:交通灯式的现场分级——把参数分成”禁止改 / 必须改 / 必须跑 / 视情况”,并前置到操作手册的最前面。因为现场最常见的事故,是有人为了快,动了那个本来不该动的开关。把”哪些绝对不能碰”写在第一页,比写在附录里有用得多。
十、这套方法什么时候不管用
最后要说清楚它什么时候不管用。一篇只讲”我的方法多好”的方法论文章是没有价值的。以下是我自己列出的、这套东西会失效的情形:
- 代理模型的冷启动开销不可忽略。当预算只够跑十几轮时,贝叶斯优化的前期探索成本可能吃掉全部收益——此时”分层粗扫 + 局部细化”反而更划算。
- 高维多目标下不成立。多目标优化在目标数超过 5 个之后仍然很难处理,本方法论明确假设目标数不超过 5。指标再多,必须先做聚合或分层。
- 压测不等于生产。短时压测反映的是稳态吞吐,生产流量的到达模式、长度分布、突发性都不一样。上线前应该做长时间浸泡测试,而不是把压测结果当成交付证据。
- 序贯检验在效应量接近阈值时仍需大样本。 always-valid 方法解决的是”随时可停”的合法性问题,它不减少所需样本量。效应量贴近阈值时,预算仍可能不够。
- 知识库本身可能被误导。如果把历史调优记录沉淀成知识库来自我加速,那么一次错误的记录会持续污染后续决策。沉淀必须附带环境指纹,并在环境变化时失效。
还有两条属于”我不会假装已经解决”的:
- 算子级优化尚未端到端自动化。融合算子、通信计算融合、图模式这些杠杆,目前仍需要人工判断与人工验证,方法论只把它们列进了搜索空间的第三阶段,没有真正做到自动选型。
- “优化后变好了”与”优化项生效了”是两件事。这里的 Prefill 改善,我给出了”很可能生效”的判断和它的依据,但没有做严格的开关对照。要把因果钉死,需要单独设计对照实验。
十一、口径与边界
因此,在把这套东西搬去别处之前,先把口径边界列清楚。
- TTFT 的 88.1% 不可单独解释为”变快了”,原因在第四节已经说明:优化前的 TTFT 数据本身失效,这个数字里同时包含了”量具修复”与”路径修复”两个效应,且没有把二者分离。
- Prefill 的 +895% 是两个同定义测量之间的比值,可以干净归因到 prefill 路径的修复;但”是哪一个开关带来的”没有做单变量对照。
- 所有数字都来自同一台 8 卡机器、同一份权重、同一批 1319 个请求,是特定版本与时点下的快照。换硬件、换模型、换 vLLM 版本,这些数字都不应被直接外推。真正可迁移的是判据(TTFT ≡ E2EL、Prefill 快于 Decode)与协议(
t = max(2σ, 3%)、功效分析、序贯控制),不是具体数值。 - 方法论部分(状态机、统计决策协议、搜索策略、多目标交付)是设计规范,不是已验证的实现报告——其中只有现场脚本那部分是实际跑过的。
回到开头那句话。我原来以为调优的难点在于”知道调哪个参数”,现在的判断是:难点在于先证明你测的那个数是真的,再证明你这次判定是有意义的,最后才轮到调哪个参数。
顺序错了,前面每一步做得越认真,离正确越远。
参考文献
[1] vLLM 文档 · 优化配置(分块预填充 --enable-chunked-prefill、图模式等):https://docs.vllm.ai/en/latest/configuration/optimization.html(2026-10-11 实测可达)
[2] Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences(第 2 版)—— 功效分析与样本量公式 n ≈ (z_α+z_β)²·2σ²/d² 的标准出处。
[3] Howard, S. R., Ramdas, A., McAuliffe, J., & Sekhon, J. (2021). Time-uniform, nonparametric, nonasymptotic confidence sequences. arXiv:1810.08240:https://arxiv.org/abs/1810.08240(2026-10-11 实测可达)—— always-valid 推断(“随时可停仍合法”)的代表性工作。
[4] Benjamini, Y., & Hochberg, Y. (1995). Controlling the False Discovery Rate: A Practical and Powerful Approach to Multiple Testing. JRSS-B. DOI: 10.1111/j.2517-6161.1995.tb02031.x
[5] Adams, R. P., & MacKay, D. J. C. (2007). Bayesian Online Changepoint Detection. arXiv:0710.3742:https://arxiv.org/abs/0710.3742(2026-10-11 实测可达)—— 即 BOCPD;ADWIN 出自 Bifet & Gavaldà (2007) 的同名论文。
关于实测数据的核验说明:第一节到第四节的压测数据来自我自己在 8 卡机器上的两轮实测,原始报告不在公开位置,因此读者无法直接复算。可替代的核验路径是两条不依赖具体数字的判据:① 只要压测未开流式输出,TTFT ≡ E2EL 就必然成立——这是定义上的恒等式,任何环境都能一分钟复现;② 只要 Prefill 吞吐低于 Decode 吞吐,就意味着 prefill 路径异常——因为前者是计算密集、后者是访存密集。真正可迁移的是这两条判据和第七节的统计协议,不是那些具体数值。
评论
填个昵称就能发,不需要注册或登录