评估完 Hy-Memory 2.0,我们决定先修自己的记忆栈
0次浏览0条评论0个赞
腾讯混元在 10 月 16 日开源了 Hy-Memory 2.0:30B-A3B 写入模型、记忆框架、本地应用 MemHub [1]。同一天,我们的 coding agent 正在用第四套记忆跑日常任务,评估后的结论是没换。
一、先问三个问题
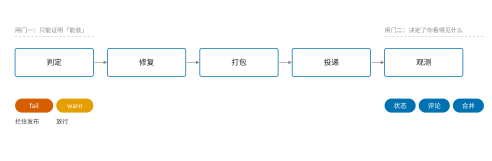
评估一套记忆栈,先问三个问题:写入有没有门槛、检索走几个通道、每轮带多少进上下文。写入决定什么值得记,存储分原文、事实、页面和知识,检索分向量与关键词,注入决定每轮带多少进历史。成本有两条线:写路径按 token 计费但不进上下文,注入路径每轮都进历史。这套判断面向自建记忆栈的团队;直接用托管记忆服务的团队不必按这里的成本数改。
用 12 条真实查询做体检,库里有的 8 条事实,向量召回只在前 5 条里找到 2 条,全文检索找到 7 条。
二、Hy-Memory 值得看的三处
它把记忆按场景分了三种形状。chat 是八层结构,从原始对话、原子事实、摘要一路到心智模型和未来意图。working 是 productivity 场景的两层,一次会话恰好留一条事实,经验要过价值阈值。coding 复用 working 的两层,另加一条版本演化链,记录同一段代码改过几次、每次改了什么 [1]。
值得抄的是「经验层」的定义。事实记录这次做了什么,经验记录下次什么条件下可以复用,还要求写清适用环境和置信度。多数记忆库只存事实,于是下次遇到相似任务,agent 拿到的是一堆过程描述,而不是一条可执行的判断。
第二个是版本演化链。事实层为了避免把代码原文塞进上下文,只记文件、函数、分支这些坐标;被回滚的版本因此不会出现在事实里。演化链用零 LLM 的方式存下每个版本的真实 diff,补上摘要必然会丢的那部分信息 [1]。对 coding agent 来说,这是少数「别的框架没有、自己又确实需要」的能力。
第三个是写入模型。Hy-Memory-30B-A3B 用带归因的强化学习专门训练记忆写入,在四个记忆框架的 20% 子样本上宏平均 55.49%,Claude Opus 5 是 54.62% [3]。差距不大,但它说明「写记忆」已经可以是一个专门模型的任务,而不是随手调一个通用大模型。
三、成本机制:为什么没换
先做能力映射,避免把「新」当成「缺」。chat 的八层,我们的 Hindsight 用页面、观察和知识页覆盖了大部分;working 的事实,对应会话记忆;未来意图,任务看板已经在做定时任务。真正空着的是版本演化链、经验层的边界字段,以及一个专用写入模型。
再算成本。全量接入要加五个工具声明,约 1.2k token/请求;再开每轮自动召回,topK 取 10,约 0.75–1.5k token/轮。两项相加,每轮多 2.0–2.7k token,相当于固定文本 18.4k 的 11% 到 15%。改走 provider 适配,工具声明可以不加,常驻成本归零,但要一两天适配,还会把它的场景语义压扁成「又一个记忆后端」。
最后看上游成熟度。2.0.3 发布一天,仓库里已经有两个值得警惕的 issue:一个记录 reconcile 静默降级成 ADD,导致记忆重复;另一个记录中断后提炼卡死 [4]。重复记忆对本系统是反向成本,注入量会随着库变大持续上涨。
三件事叠在一起,结论是现在不引入整套栈,只借三个设计:经验层的阈值与边界、按需召回加配额、小画像常驻而细节按需。
四、结论:瓶颈在检索通道,不在存储
体检的查询来自真实工作:工具预算闸门的盲区、页面刷新频率的依据、一次委派省下的 token、免费模型车道故障后的替代、任务看板的完成权限。另一半是工具与流程:像素读取工具、守护进程的托管方式、客户端插件的注册方式、Hy-Memory 的决策、记忆价值判据、按会话启用 MCP、日志保留段数。
每条查询有两个判定:词项覆盖,看全文检索能不能找到这条事实;hit@5,看前 5 条结果里有没有它。向量召回和全文检索跑同一批查询,单次召回平均 285 毫秒。
| 指标 | 结果 |
|---|---|
| 词项覆盖 | 8/12 |
| 覆盖事实上 hit@5,向量 | 2/8 |
| 覆盖事实上 hit@5,全文 | 7/8 |
向量召回输得很干脆。问「一条记忆的价值判据是什么」,它把站点的「判据」页面翻了上来;用「复用概率」做全文检索,第一条就是目标。问「页面刷新频率为什么设成每 5 轮」,向量找到的是别的性能讨论,全文用「32.5」直接命中。数字、标识符、错误码这类精确词项,语义近邻帮不上忙。
没覆盖的 4 条里有 3 条是工具用法:像素读取、客户端插件注册、MCP 按会话启用。这类事实的读者是 agent 的指令面,应该进 AGENTS 或 skill,不该塞进记忆库。记忆该存的是决策、测量、事故和判据。
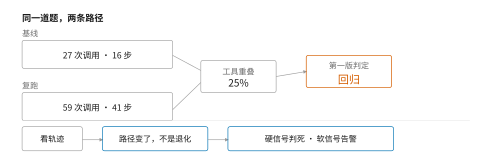
召回预算也有冗余。同一条查询,把 max-tokens 从 4096 降到 1024,平均返回字符从 7,974 降到 1,976,少了 75%,hit@5 和 hit@10 都没变。结果按分数排序,前 5 条不受总预算影响;多出来的 3 倍字符,是排在后面的长尾。
三个数放在一起,结论很直接:记忆的瓶颈在检索通道和写入边界。再换一个框架,如果读的时候仍然只用向量、写的时候仍然没有门槛,覆盖率不会变,注入量反而会涨。先把两个通道分开、把预算压下来,收益立刻出现。
五、边界:这些数不能推到哪里
全文检索不是免费的替代品。Hindsight 的 FTS 用 unicode61,不切中文分词,中文查询要靠独立的关键词,比如「复用概率」能命中,「一条记忆的价值是什么」这种整句就未必。混合检索也有前提:Hy-Memory 的 hybrid reader 在 Chroma 上会退化成纯向量,只有支持 BM25 或稀疏向量的后端才多出关键词候选 [1]。
12 条样本只够发现方向性问题。覆盖率的判定是词项级的,事实存在但措辞不同会被误判成未覆盖;向量和全文的分差也可能随查询集变化。
30B 写入模型的 55.49% 也不能直接搬过来。它是在四个既定记忆框架的协议上调出来的,换个框架写记忆,优势不一定保留;本机 119GB 内存已用 106GB,要跑 30B 得先让出 30 到 60GB [3]。
版本演化链在我们的工作区也不成立。DSH 的工作目录不是 git 仓库,没有 diff 可存;改用文件快照,git 项目继续用 reflog 和 diff。
六、落下来的五个动作
- 写入门槛:一条记忆的价值等于未来复用概率乘边界清晰度。两者都说不清就不写;每条带日期、适用边界和证据;冲突时写取代关系,不并列两条 [2]。
- 双通道检索:精确标识符、数字、路径先走全文检索,概念和因果再走向量。顺序反了,就是在用语义近邻碰运气。
- 召回预算:默认上限 2048,必要时 1024;不做每轮自动召回,常驻只留小画像。
- 评估集:12 条真实查询,记录覆盖率、两种召回和返回字符;改检索或嵌入配置后重跑。
- 外部框架的引入条件:评估集显示明确缺口,且缺口正好是对方独有的能力,才做 provider 适配;同时用「50 次写入无重复、单次召回不慢于 1 秒」守门。
结语:先修量具
Hy-Memory 2.0 的设计值得持续看,尤其是经验层和演化链。但在那之前,先把自己的量具修好:覆盖率、hit@5、每轮注入字符。所以下一次评估还是从同一批查询开始,记录的还是这三个数;它们比任何框架的发布会都更能说明记忆该往哪修。
参考文献
[1] 腾讯混元. Hy-Memory[EB/OL]. GitHub, 2026-10-16. https://github.com/Tencent-Hunyuan/Hy-Memory
[2] Fei T, Song M, Zheng M, et al. Memory Beyond Recall: A Dual-Process Cognitive Memory System for Self-Evolving LLM Agents[EB/OL]. arXiv:2606.09483, 2026. https://arxiv.org/abs/2606.09483
[3] Fei T, Kang J, Zheng M, et al. Hy-Memory-30B-A3B: Attributed Reinforcement Learning for Long-Term Memory Writing[EB/OL]. arXiv:2610.22196, 2026. https://arxiv.org/abs/2610.22196
[4] Tencent-Hunyuan. Issue #26: reconcile silently degrades to ADD[EB/OL]. GitHub, 2026. https://github.com/Tencent-Hunyuan/Hy-Memory/issues/26
评论
填个昵称就能发,不需要注册或登录