从 67B 到 671B 再到 1.6T:DeepSeek 近三年换了五种结构,那道没变过的判断标准
0次浏览0条评论0个赞
2024 年的 DeepSeek-LLM 是 67B;2026 年 4 月的 DeepSeek-V4-Pro 是 1.6T(49B 激活)。到 2026 年 9 月的 V4.1-Flash,backbone 552B(另有 196B Engram),每 token 的 KV 足迹 890 字节。两年八个月,结构换了五次。
2026-10-17 的第十次更新(V4.1-Flash-1017)连结构都没换——它换的是后训练,也是三年来第一次「省资源」和「不掉点」同时发生(见 §13)。
每一次换结构都只做一件事:拆掉上一代最贵的那根成本项。
成本不会消失,只会换一个位置。贯穿五代的判据只有一条:省资源,但不掉点。
1. 一条规律:五次换结构,都在拆上一代最贵的成本
结构换了五次,指的是:潜向量 → 先压缩再稀疏 → 条目共享 → 量化(把权重或 KV 压成更低比特,用精度换带宽)→ 编码器-解码器。每一次都是换结构,而不是省着用。
按成本项走,每一代只回答一个问题——它拆掉哪根成本、付出什么、把问题推到哪。
拆掉的位置决定下一代的问题。V2 把 KV 压下去,占用就从”存不下”变成”搬不动”,于是才有 V3.2 之后的稀疏化;当 KV 便宜到可以忽略,成本又转到”思考”上,V4.1-Flash 真正的产品设计因此成了一个 effort 旋钮。
主线第 0–7 代对应 V 系列(LLM → MoE → V2 → V3 → V3.1 → V3.2 → V4 → V4.1-Flash);R1 是自第 3 代分出的旁支——它基于 V3-Base 训练,能力又蒸馏回主线(V3-0324 / R1-0528)。代际编号是一种呈现方式,不是官方分类;日期取论文 arXiv 提交日或模型卡上线日。
这条线是一条成本拆解线:DeepSeekMoE 拆预训练 FLOPs;V2 用 MLA 拆推理期的 KV cache(KV cache 是把每一步算过的中间状态存下来、免得重算的缓存,MLA 把它压成远小于逐头 K/V 的潜向量);V3 在 671B 规模上验证前两项仍成立;R1 拆”获得能力要花多少人工监督”;V3.2 拆长上下文里随长度线性增长的那部分;V4 把”先变小、再看着办”做成结构;V4.1-Flash 把每 token 的 KV 足迹压到 890 字节。
把这条规律说全:每一次成功的成本优化都不会结束问题,它只是把问题推到下一个更值钱的地方。
读者是想做技术选型、容量规划或成本判断的人;只想看模型强弱排名的话,这里不提供座次,只拆成本项。
图 1:DeepSeek 演进主线(第 0–7 代 + R1 旁支)。据论文与模型卡整理,各代机制与日期见后文与参考文献。
2. 九次发布一张表:每次拆的是哪根成本,代价又落在哪
下表铺开覆盖范围(至 2026-09-10 的 DeepSeek-V4.1-Flash)。「自述继承」列引论文原文或模型卡;第 0、1 两代该列在论文与卡片中无对应措辞,为归纳结果。
| 世代 | 模型(发布) | 规模(总/激活) | 本代关键变化 | 自述继承 |
|---|---|---|---|---|
| 0 | DeepSeek-LLM(2024-01-05) | 7B / 67B,2T tokens | scaling law:先研究扩展规律再花钱 | 为后面所有代立预算纪律(归纳) |
| 1 | DeepSeekMoE(2024-01-11) | 2B–145B | 细粒度专家 + 共享专家隔离 | 拆「训练成本」第一根(归纳) |
| 2 | DeepSeek-V2(2024-05-07) | 236B / 21B,128K | MLA:KV 压成潜向量 | DeepSeekMoE 架构原样沿用[3] |
| 3 | DeepSeek-V3(2024-12-27) | 671B / 37B,14.8T | FP8 混合训练、无辅助损失均衡、MTP | 「架构基于 V2 上已充分验证的 MLA + DeepSeekMoE」[4] |
| 4 | DeepSeek-V3.1(2025-08-21) | 671B / 37B | 混合思维(一个模型两种模式)、UE8M0、长上下文数据扩容 | V3 谱系;Terminus 的 128K 权重是 V3.2 的起训点[8] |
| 5 | DeepSeek-V3.2(2025-09→12) | 671B / 37B | DSA 稀疏注意力、scalable RL、agentic 数据合成 | 唯一架构改动 = 引入 DSA;从 V3.1-Terminus 续训[8] |
| 6 | DeepSeek-V4(2026-04 预览,论文 arXiv v1 同月) | Pro 1.6T / 49B;Flash 284B / 13B,1M | CSA+HCA 混合注意力、mHC、Muon、OPD | 「保留 DeepSeekMoE 框架与 MTP」;CSA = DSA + KV 压缩[9] |
| 7 | DeepSeek-V4.1-Flash(2026-09-10) | 552B(+ Engram 196B)/ prefill 8B · decode 16B | CED 编码器-解码器、CSA2、FP4 main KV(890 B/token) | 模型卡小标题即「Pushing the Limits of KV Cache Compression」[19] |
| 旁支 | DeepSeek-R1(2025-01-22) | 671B / 37B | 纯 RL 涌现长 CoT;GRPO + 规则奖励 | 基于 DeepSeek-V3-Base[4][5] |
主线之外还有一批版本迭代,它们都建立在同一架构上,只做数据与解码增强,因此不单列世代:
- V3-0324 / R1-0528(2025 春)——R1 的能力蒸馏回主线,见 §7.1;
- V4-Pro-0813 / V4-Flash-0731(2026-07/08)——正式版,见 §11;
- V4-Pro-DSpark(2026-06-27)——投机解码轨件,见 §11;
- V4-Flash-Vision-Exp(2026-08-31)——首个多模态实验版,见 §11。
- V4.1-Flash-1017(2026-10-17)——同架构的后训练更新,首次同时缩短运行时间与输出长度,见 §13。
3. DeepSeek-LLM(2024-01):先量清「多少数据配多少参数」,再定训练量
这代没有新架构,立的是预算纪律。
论文里的动机很直接:以往文献对「多少数据配多少参数」给出的结论各不相同,所以团队干脆把 7B 和 67B 两个开源配置的扩展规律自己研究了一遍,再按研究结果决定训练量;配套 2T tokens 语料与 SFT + DPO[1]。
它的意义要到后面才显出来:后面每一代的「省」,都是相对一条算得清的学习曲线在省。没有这条曲线,「省」就没有参照系——你不知道自己省掉的是浪费还是能力。
4. DeepSeekMoE(2024-01):参数总量做大,每 token 只算其中一小部分
继承:67B 稠密基座与 scaling law 预算纪律[1]。拆解:预训练 FLOPs。
稠密模型的问题是:参数越大,训练越贵,而推理时每次前向都要把全部参数算一遍。MoE(混合专家)的思路是把参数总量和每 token 实际用到的参数分开——总参数做大,但每个 token 只激活其中几个专家。DeepSeekMoE 在此之上做了两个改动。
改动一:细粒度专家分割。传统 MoE 把专家做大做粗;DeepSeekMoE 把专家切成更细的粒度。总参数不变时,专家更小更多,每个专家被迫更专门化,可组合的专家对也更多。论文摘要把 fine-grained expert segmentation 与 shared expert isolation 列为两大核心创新[2]。
改动二:共享专家隔离。每层特设 2 个恒激活的共享专家,吸收所有 token 都要学的通用知识。这样路由专家不必被迫「什么都学一点」,可以专心做专长。路由的打分与 top-k 选择(V2 沿用此方案)[3]:
读法:每个专家 有一个门控向量 。拿当前 token 的隐状态 和它做内积,就得到这个专家的匹配分。归一化之后,只保留排名最前的 个(V2 配置 6 个),其余专家在这一层完全不算。
总参数远大于激活参数,就是这么来的。
图 2:DeepSeekMoE 结构——共享专家恒激活,路由专家细粒度 top-k 选择。
配置(V2 论文超参一节,可直接核对的硬数字)[3]:
| 项目 | 数值 |
|---|---|
| Transformer 层数 / hidden | 60 / 5120 |
| 每层共享专家 | 2 |
| 每层路由专家 | 160 |
| 每 token 激活路由专家 | 6 |
| 路由专家中间维 | 1536 |
| 总参数 / 激活参数 | 236B / 21B |
| 上下文长度 | 128K |
证据(arXiv 摘要 + V2 §3.2.3)[2][3]:同样性能下省了多少——
| 比较 | 结果 |
|---|---|
| DeepSeekMoE 2B vs GShard 2.9B | 相当性能,而 GShard 有 1.5 倍专家参数与计算 |
| DeepSeekMoE 16B vs LLaMA2 7B | 相当性能,计算只有 约 40% |
| DeepSeekMoE 145B vs DeepSeek 67B | 相当性能,计算只有 28.5%(甚至 18.2%) |
| V2 训练成本 vs DeepSeek 67B | −42.5%、吞吐 5.76×、8.1T tokens |
这一路继承了多少代? 「共享专家 + 细粒度路由」这八个字从 2024-01 到 V4.1-Flash 几乎没变,变的只是规模:V3 每层 1 共享 + 256 路由、激活 8;V4-Pro 专家中间维 3072、V4-Flash 2048,均激活 6;V4.1-Flash 是 1 共享 + 384 路由、激活 6[4][9][19]。V3 论文对 DeepSeekMoE 的评价是它已在 V2 上「thoroughly validated」,所以直接原样继承并放大。
留下的成本:训练省了,推理没省——自回归解码的 KV cache 还完整挂着。这正是 V2 要拆的那一根。
5. V2(2024-05):KV 从 32768 维压到 576 维,推理成本第一次成为一等公民
问题定义。 自回归解码每生成一个 token,都要读一遍全部历史 KV。MHA 把每个头的 K/V 都缓存起来,头数越多、上下文越长,显存和带宽压力越大——长上下文的吞吐是被 KV 读取卡死的,不是被算力卡死的。
MLA 的做法是:不再缓存每个头的 K/V,只缓存一个低秩联合压缩后的「潜向量」,推理时再用可学习上投影还原各头的 K/V。这是一笔清楚的交换:用一点计算换一大截显存。而且上投影矩阵可以被吸收进 Q、O 的投影里,所以解码阶段根本不做还原,压缩只发生在缓存这一侧。
位置编码上额外保留一路解耦的 RoPE 键(64 维,不参与压缩):因为 RoPE 对 key 是位置敏感的,与低秩压缩在数学上不相容,只能拆开。V2 论文 §2.1.3 明写「RoPE is incompatible with low-rank KV compression」[3]。
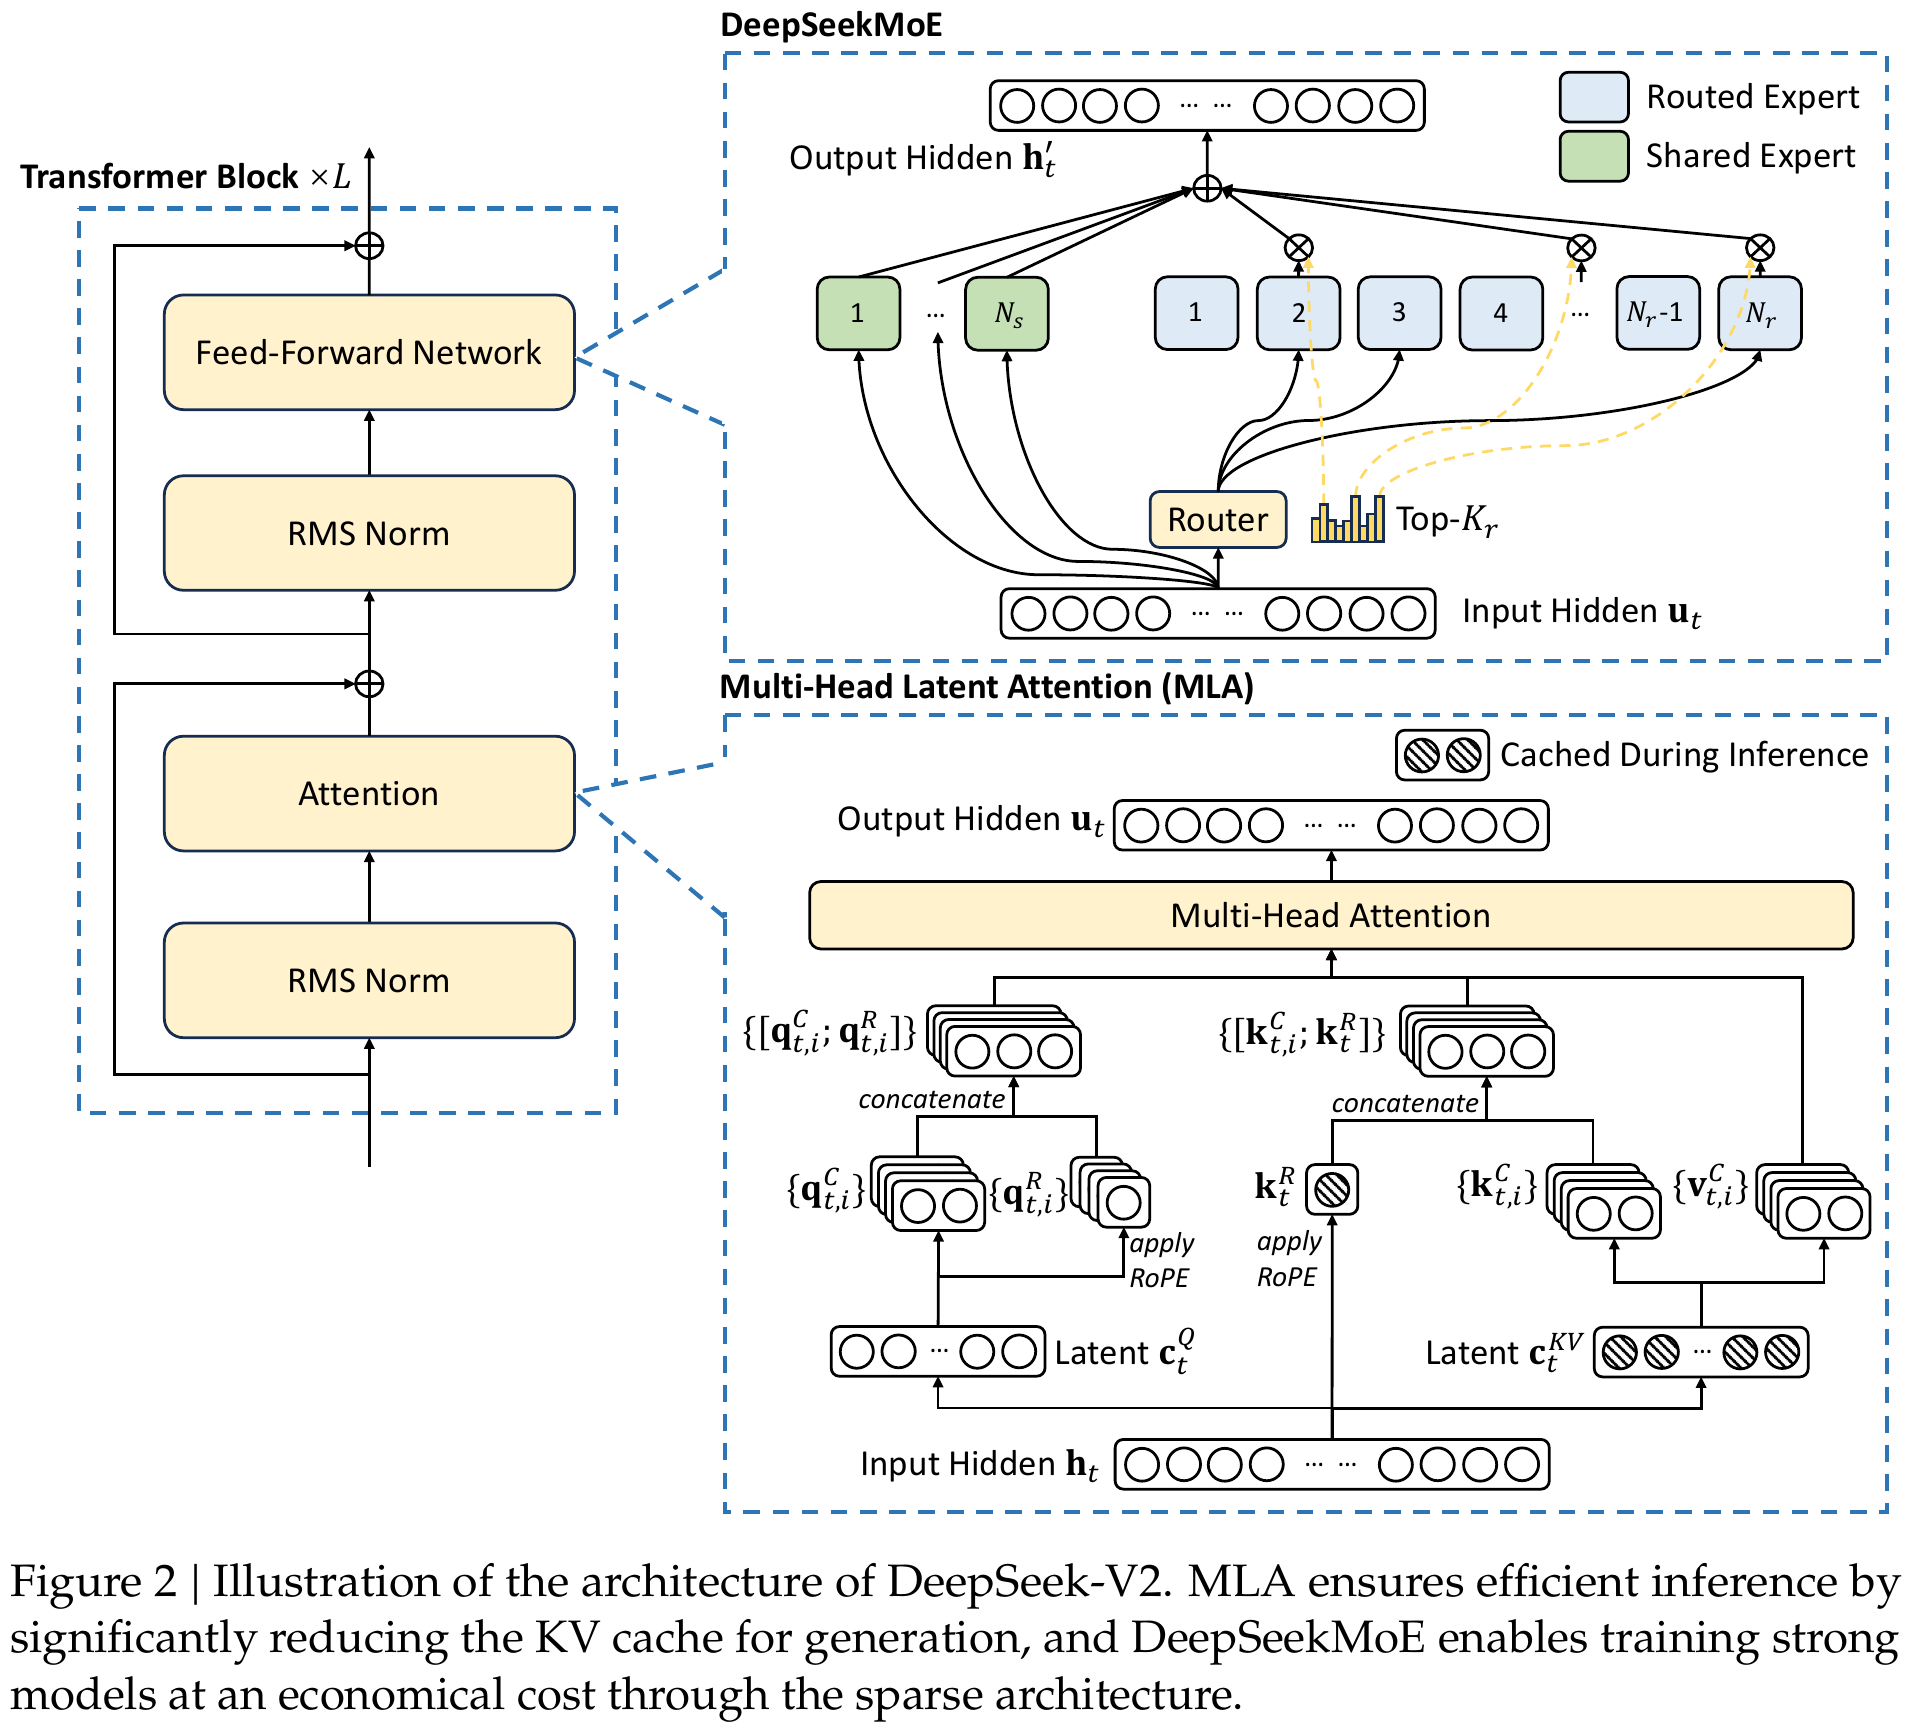
图 3:DeepSeek-V2 整体架构(DeepSeekMoE + MLA 注意力)。来源:论文[3] Figure 2。
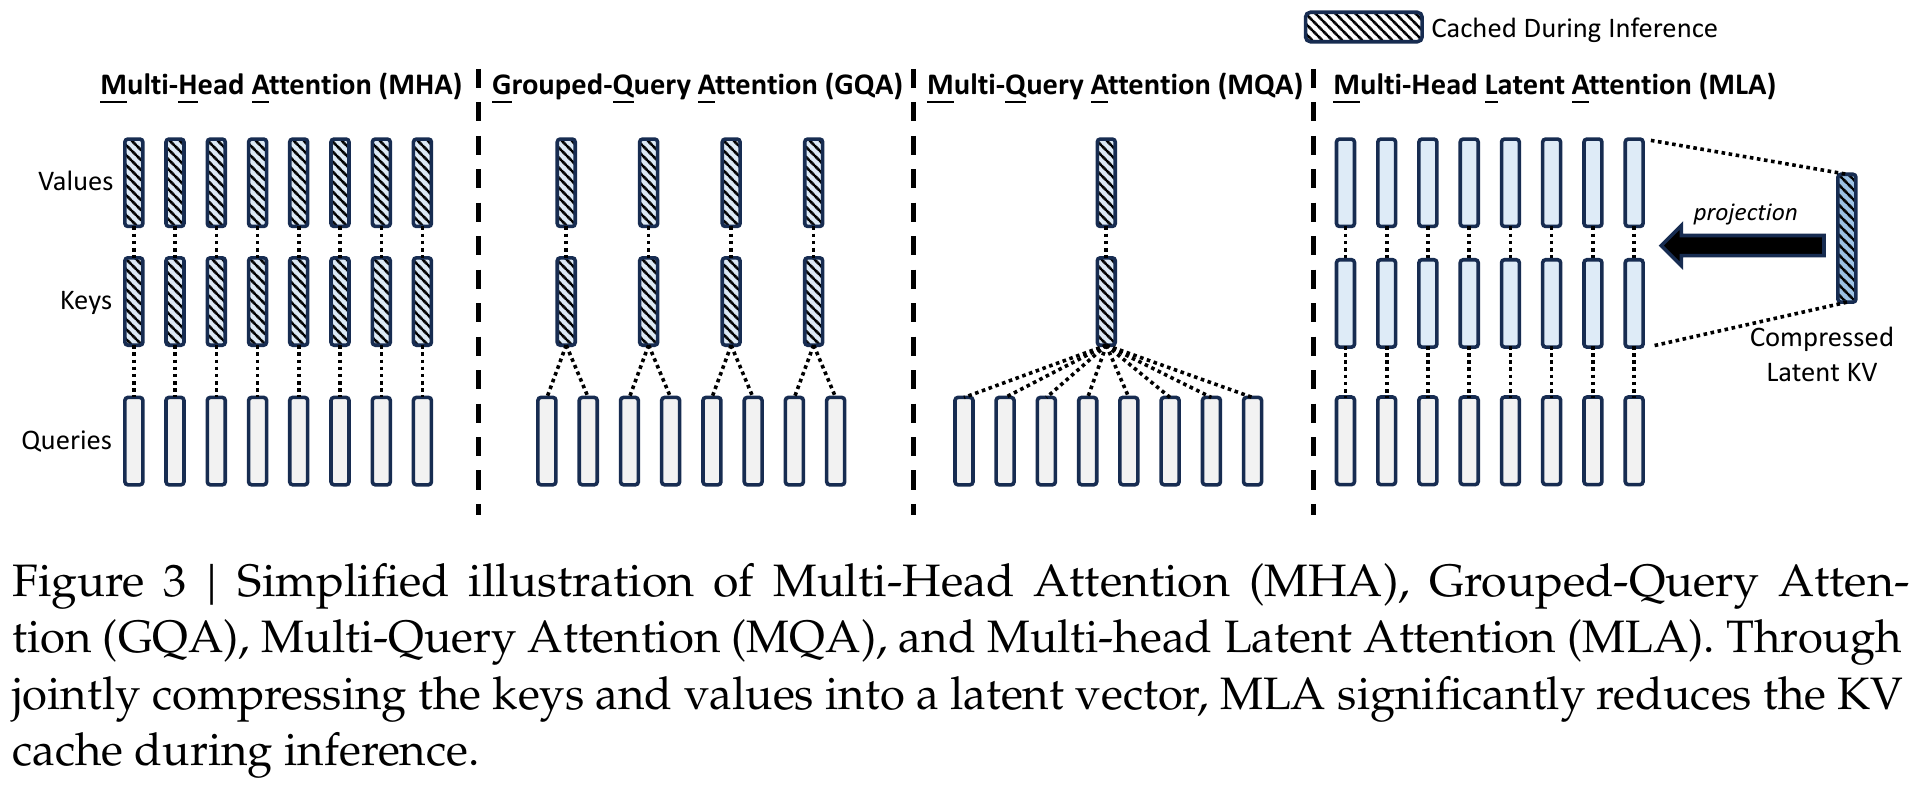
图 4:MHA、GQA、MQA、MLA 四种注意力方案的 KV cache 结构对比。来源:论文[3] Figure 3。
省了多少——按配置直接算(V2/V3 两代配置一致[3][4]):
32768 → 576,按 pure-KV-slot 口径是 1/56.9——这里的「槽位」只算每 token 存下来的 KV 维数本身,不含 per-head 的额外存储与元数据,所以它不是端到端的显存降幅;但论文自报的 −93.3% 是相对 DeepSeek 67B 的整体口径(层数与注意力配置都不同),不能和这里的 1/56.9 直接相减或互相换算[3]。两个数各自都对,前提是别把它们放在同一个基准上。
长上下文侧,V2 用 YaRN 把窗口从 4K 扩到 128K(scale s=40、α=1、β=32,目标上限 160K),并按自家注意力调整了长度缩放因子[3]。
证据。 −93.3% KV 之后,128K 上下文第一次在开源档位可用;吞吐 5.76×。更值得注意的是论文对注意力的定位——MQA/GQA 的消融(Appendix D.1)证明它们省了 KV 但性能不如 MHA,而 MLA 论文原话是「achieves better performance than MHA, but requires a significantly smaller amount of KV cache」[3]。这是全篇第一次出现「省资源不掉点」的严格口径,之后每一代都在重复它。
留下的成本。 MLA 一路被继承到 V3.1-Terminus(V3.2 论文明确写它从 V3.1-Terminus 的 128K checkpoint 续训[8]),但V4 换掉了注意力这条线:V4 的 core attention 是 Shared Key-Value MQA,每条(压缩后的)KV 条目既当 key 又当 value,不再给每个头还原 K/V。这是整条线上唯一一次「注意力模块整体重做」[9]。
6. V3(2024-12):671B 上 MLA + MoE 仍成立,但规模放大带来三笔新账
V3 的定位很明确:把 MLA + DeepSeekMoE 原样搬上 671B,然后处理规模放大后才出现的三个新问题。论文原话是架构基于 V2 已验证的 MLA + DeepSeekMoE,它的贡献在 FP8、无辅助损失均衡、MTP[4]。
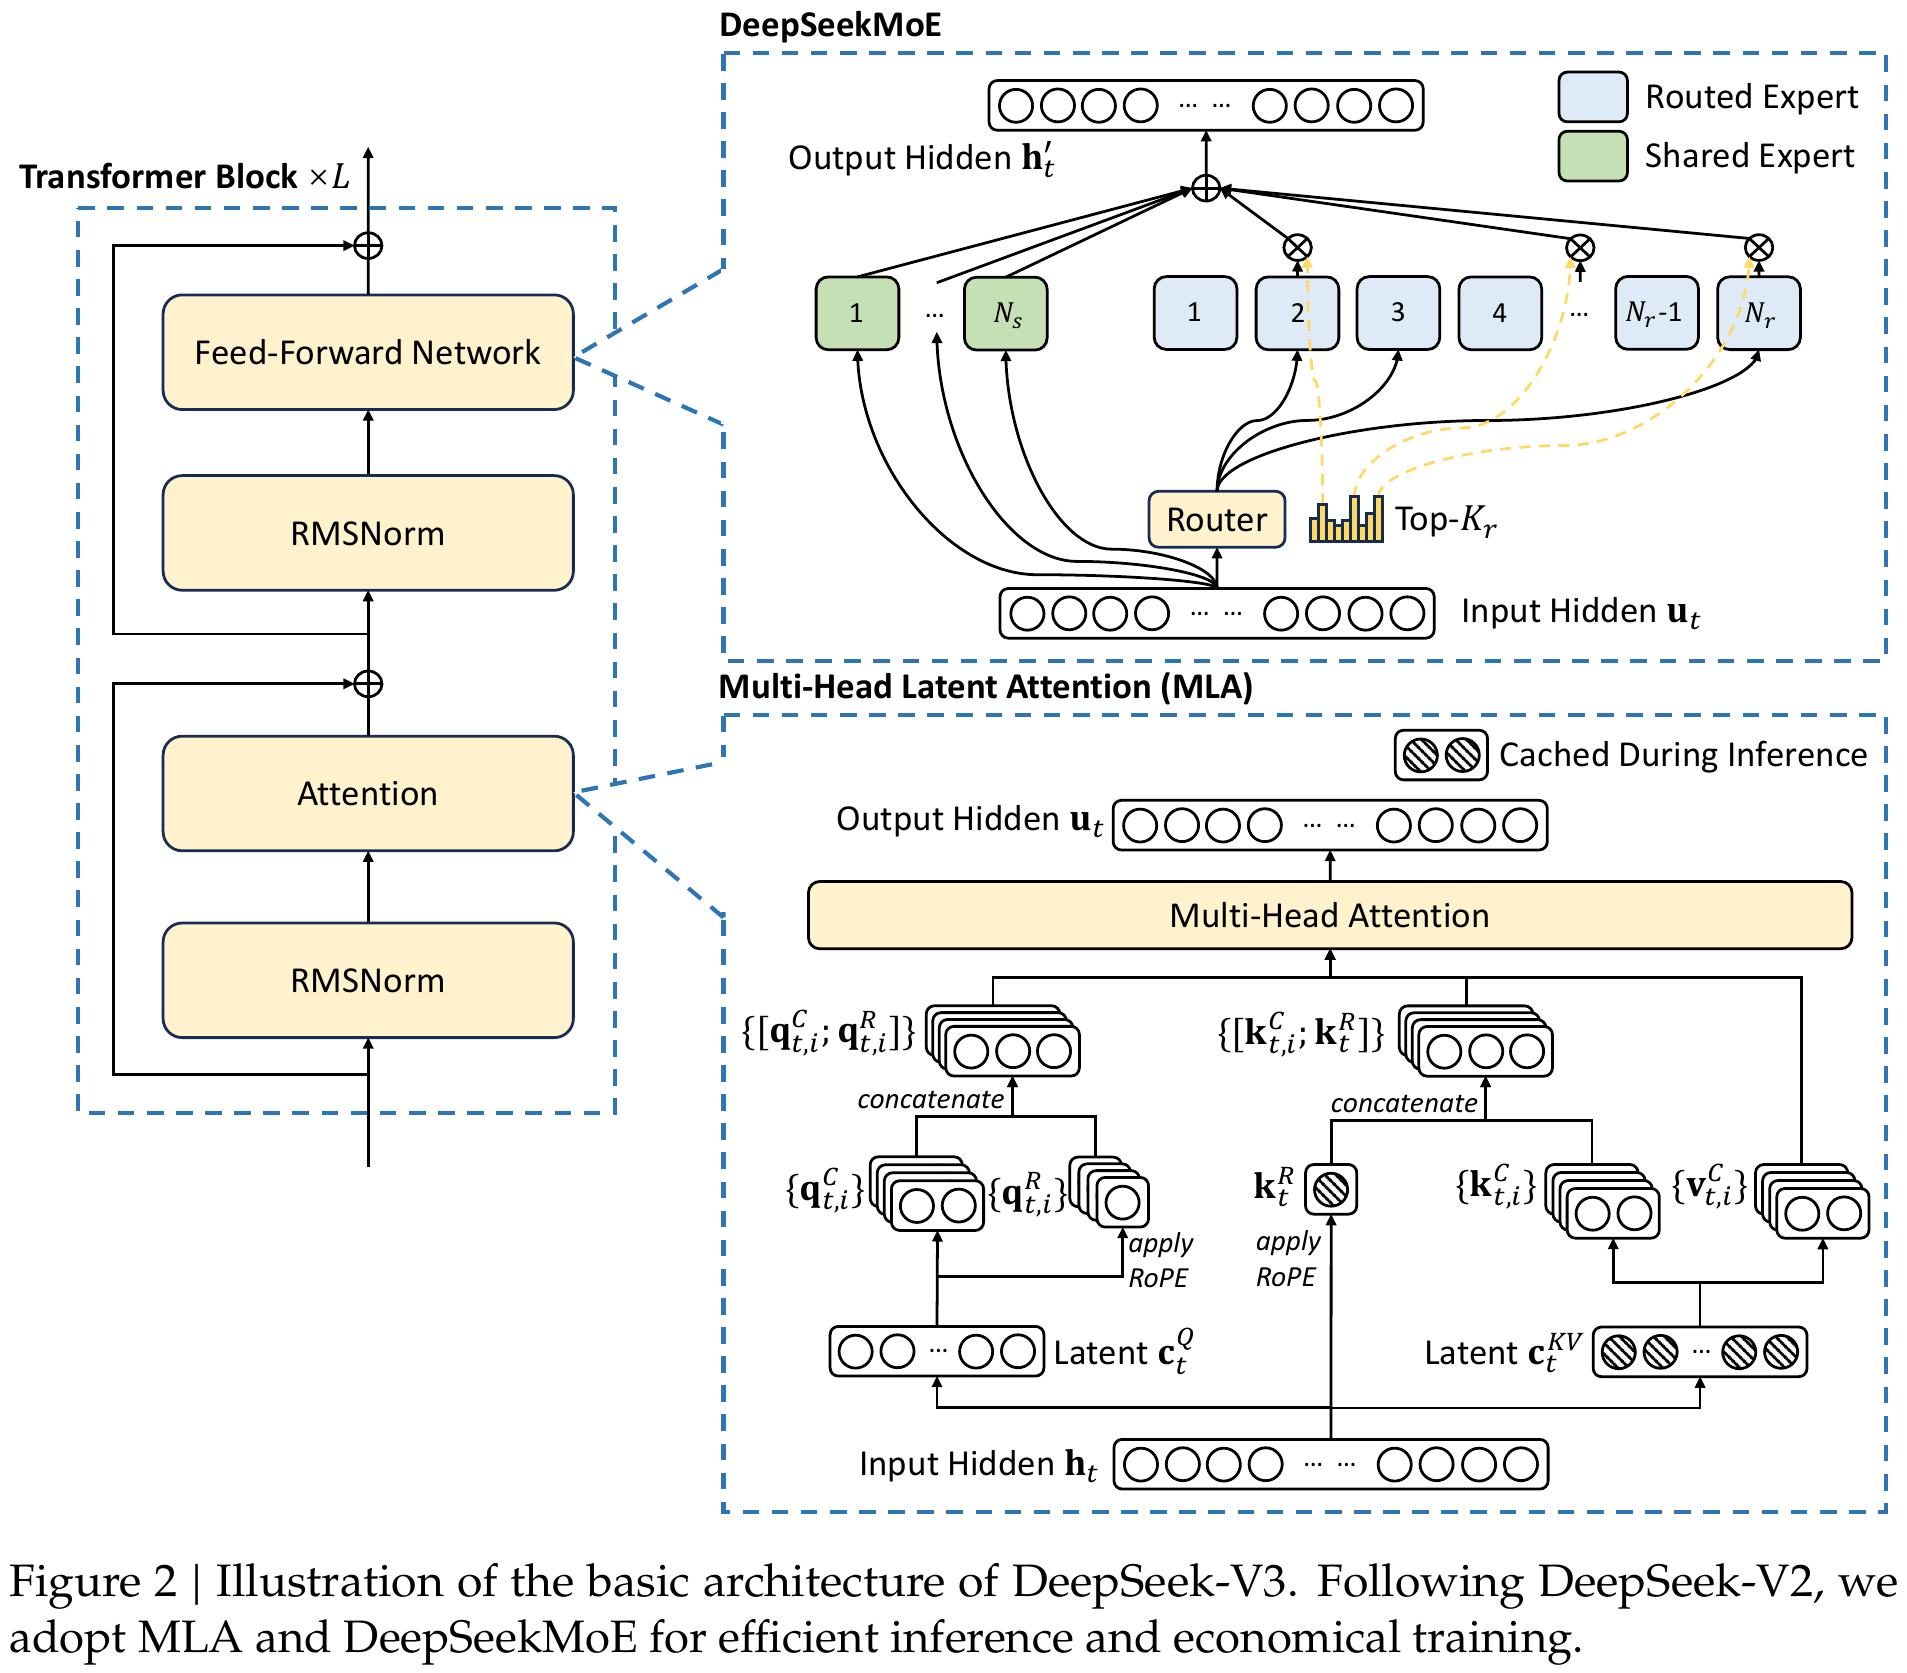
图 5:DeepSeek-V3 整体架构——看点是 MLA 注意力与 DeepSeekMoE 同处一个 block:右侧 Router 先选 Top-Kr 个路由专家,再与恒激活的共享专家相加。来源:论文[4] Figure 2。
规模与成本(论文 Table 1 + §3.6)[4]:
| 项目 | 数值 |
|---|---|
| 总参数 / 激活参数 | 671B / 37B |
| 预训练 tokens | 14.8T |
| 预训练 GPU 时(H800) | 2664K($5.328M @ $2/时) |
| 上下文扩展 | 119K($0.238M) |
| 后训练 | 5K($0.01M) |
| 合计 | 2788K GPU 时 ≈ $5.576M |
| 层数 / hidden | 61 / 7168 |
新问题一:精度不够用。 671B 参数全精度训练太贵,V3 用 FP8 混合精度——GEMM 输入 FP8、累加 FP32,细粒度缩放(1×128 tile 的 group-wise scale 因子),反向也 FP8 化省带宽。缩放形式(§3.3):
是该 tile 的缩放因子,除完再裁到 FP8 可表示的 ±448。权重与激活都走 tile/block 级缩放,让 FP8 只有约 2 位指数位也不炸[4]。
新问题二:专家负载不均。 MoE 天生有专家被抢、被闲的问题。传统做法是加一个辅助 loss 硬压负载,但那会伤模型。V3 改成用偏置动态调路由(§4.2):
意思是:某个专家这一轮负载 高于平均负载 ,就把它的门控偏置 往上调一点,让它少被选;欠载的往下调。 是更新速度(V3 取 0.001,到 14.3T tokens 后归零),另有序列级 balance loss 权重 10⁻⁴ 兜底[4]。用一条符号更新代替一个 loss 项——这是「不加辅助损失」的字面含义。
新问题三:训练信号太稀疏。多 token 预测(MTP):一次前向预测未来多个 token,训练目标额外加一项。V3 的 MTP 深度设为 1(V4 同为 1,说明三代没变)。收益有两层:训练信号更密;部署时可当 speculative 目标准备解码加速——这是 V4 时代 DSpark 的思想源头之一[4]。
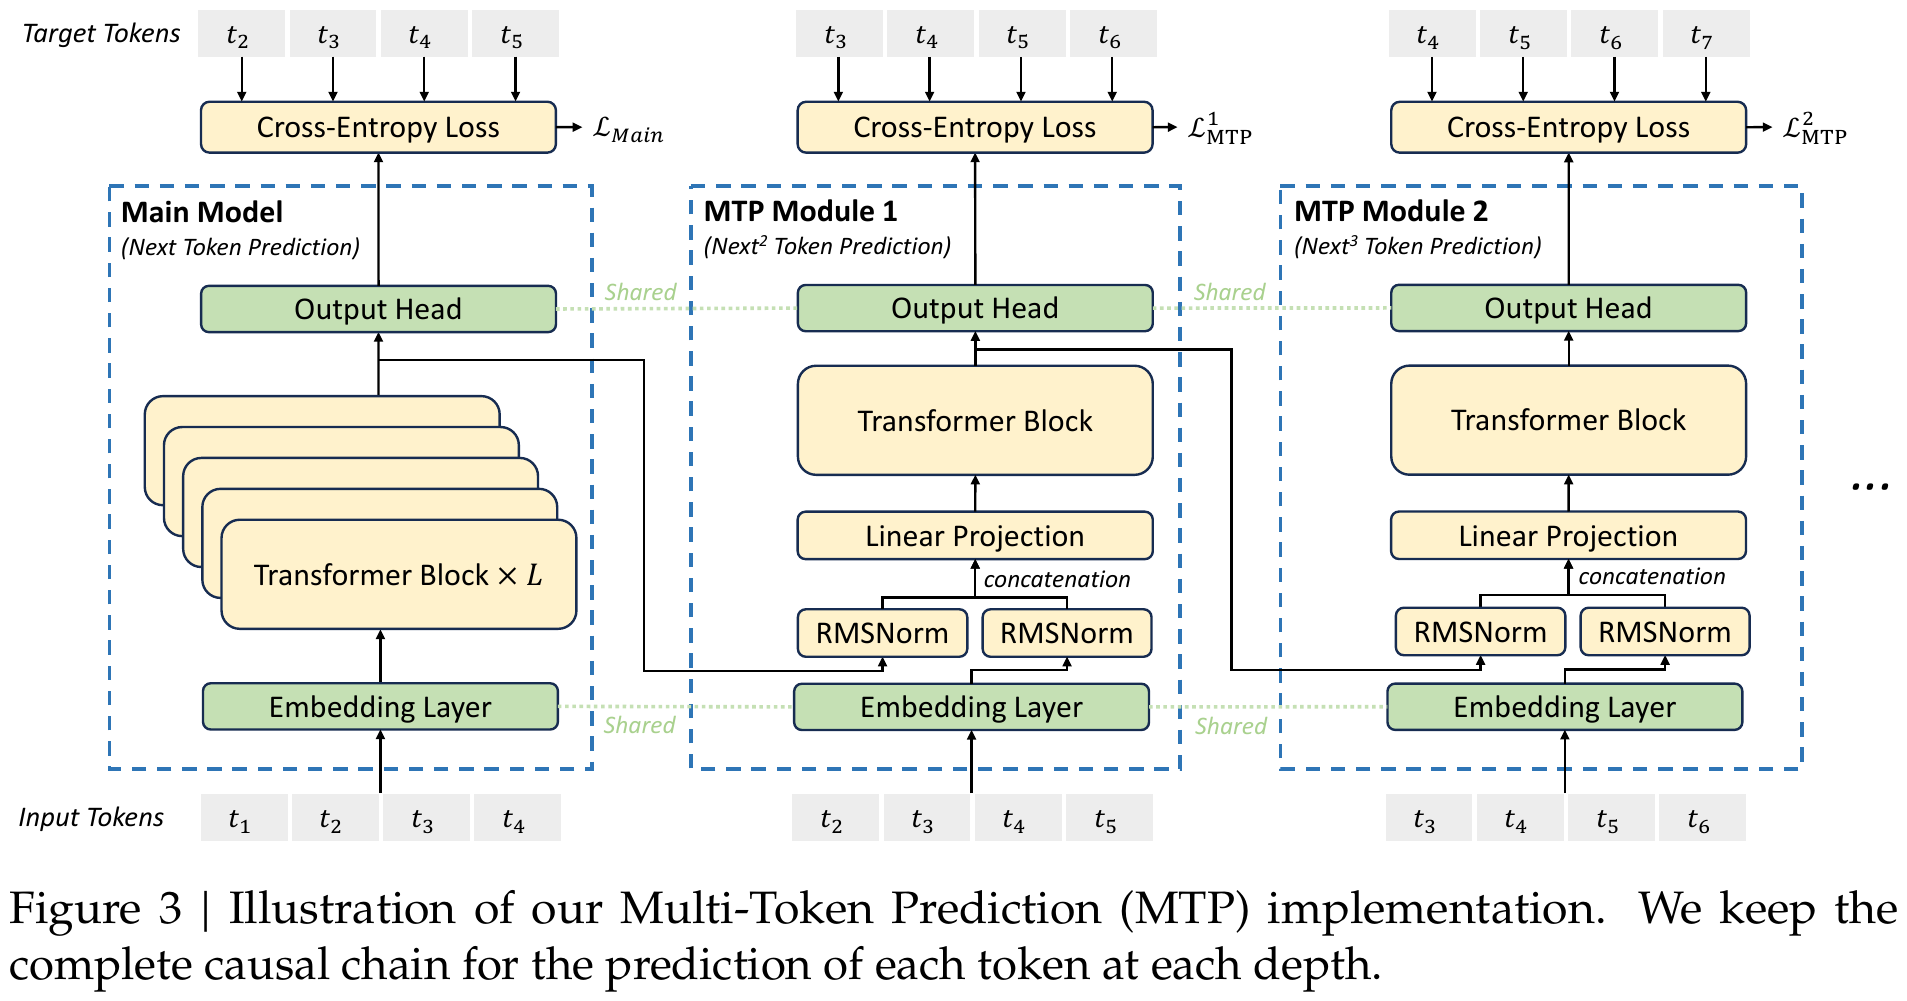
图 6:多 token 预测(MTP)机制——看点是主模型与各 MTP 模块共享 embedding 与输出头,分别预测第 1/2/3 个后续 token,并各自算一份损失(L_main、L_MTP¹、L_MTP²)。来源:论文[4] Figure 3。
证据(§4.1/§5)[4]:
- 训练稳定性:论文原话「we did not encounter any irrecoverable loss spikes or have to roll back」——14.8T tokens 全程无不可恢复尖峰、无回滚;
- 两阶段上下文扩展:32K → 128K;
- 在 MMLU、MATH、Codeforces 等基准上与 Llama-3.1-405B、Claude-3.5-Sonnet 同期对比取得头部成绩。
这条继承是全篇最硬的演进证据之一。 V4 论文逐项核对了 V3 的这三项。首先,它保留了 DeepSeekMoE 框架与 MTP(论文自述「retain the DeepSeekMoE framework and Multi-Token Prediction strategy」)。其次,无辅助损失均衡的两个超参完全相同:更新速度同为 0.001、balance loss 权重同为 10⁻⁴。唯一的改动是亲和度激活从 Sigmoid 换成 Sqrt(Softplus),并移除了「每 token 最多发 4 个节点」的限制[9]。
留下的成本:架构与训练都省了,能力怎么来?当时主流答案还是大规模 SFT 长思维链。R1 要拆的就是这根。
7. R1(2025-01):不教过程,用规则奖励让长思维链自己长出来
R1 不在 V 系列编号里,它是自 V3-Base 分出的旁支:前几代拆的是钱,R1 拆的是监督。
问题在于 SFT——它依赖大量人工或机器造的长思维链,过度依赖监督会鼓励模型「照背」。R1 论文的原文表述是:对人工标注推理轨迹的依赖会「hinders scalability」[5]。
范式(R1 论文 §1–§2)[5]:
- R1-Zero:直接基于 V3-Base 做大规模 RL,不用 SFT 冷启动;
- 奖励只看最终答案正确性(规则奖励),不对推理过程施加约束;
- RL 框架是 GRPO。
GRPO 相对 PPO 的差别其实只有一处,但很关键:同一个问题采样 G 个回答,用组内奖励的标准化值当作「优势」估计。
为什么这样就够?因为同组答案难度相当、奖励均值相近,组内标准化本身就已经消掉了 baseline 的作用。于是整个价值网络(value model)可以省掉。目标里再加一项对参考模型的 KL 惩罚,防止策略跑偏太远。机制见论文 Figure 3 与 Eq.2–3[5]。
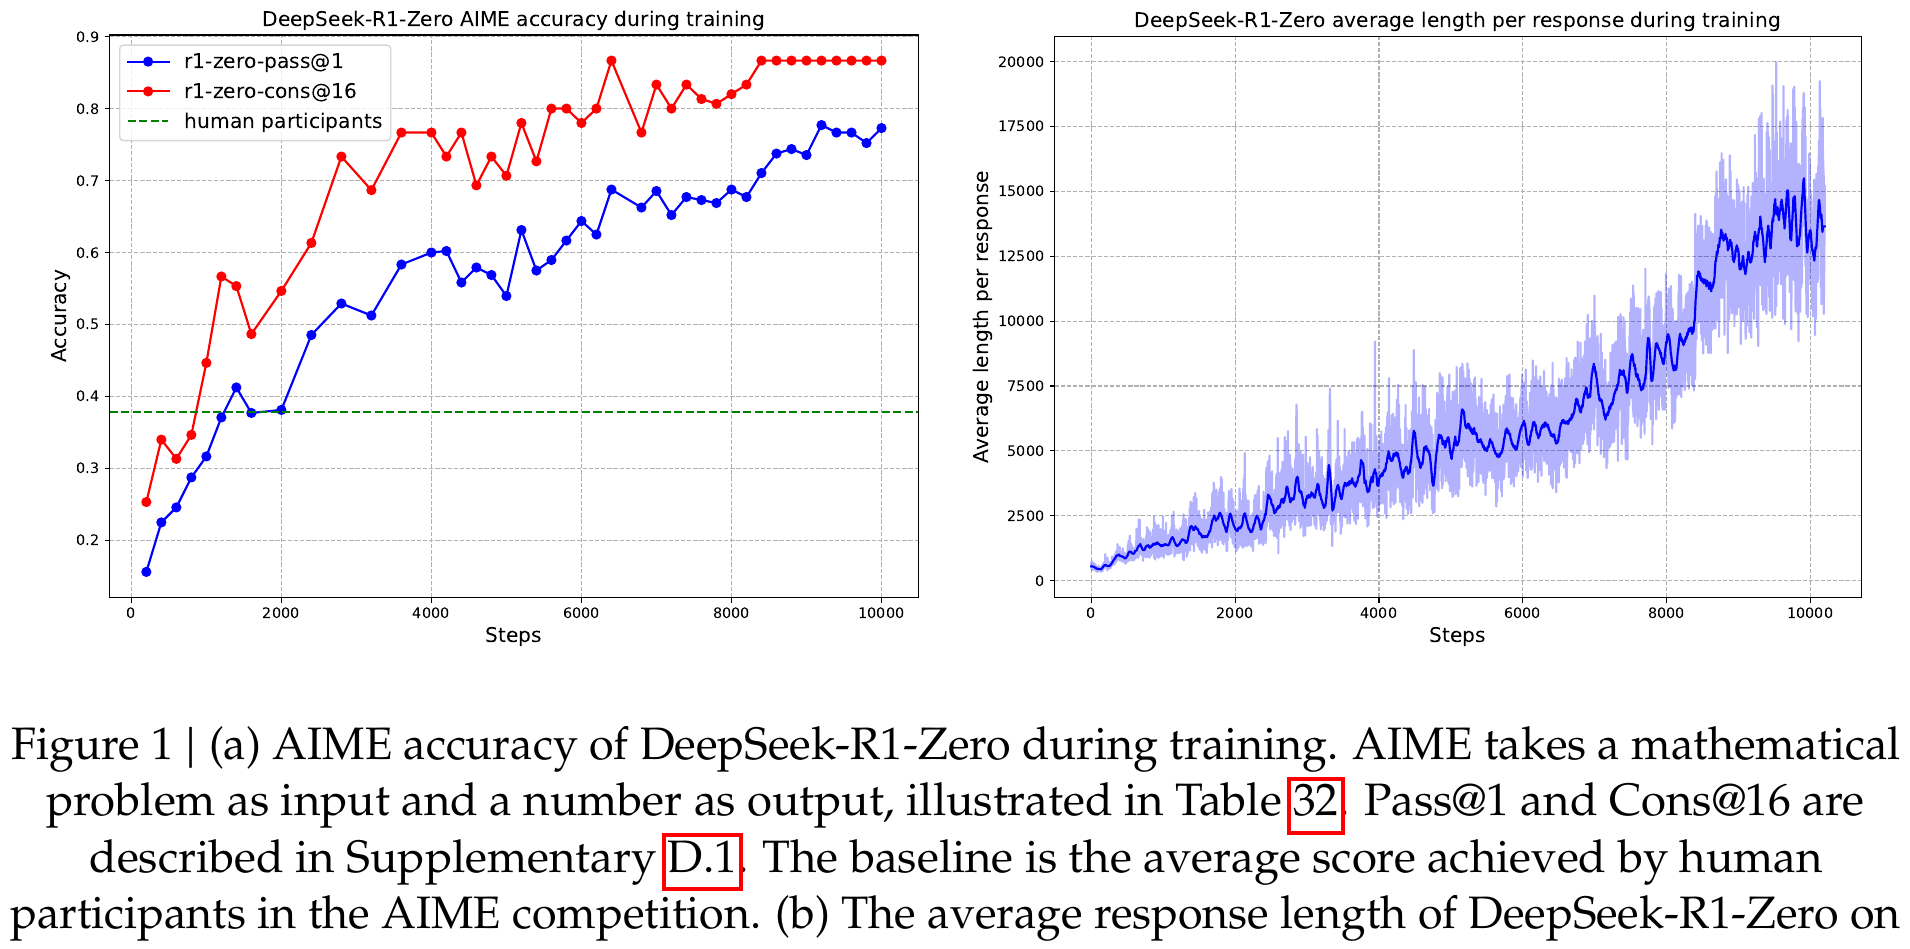
图 7:R1-Zero 的 RL 训练曲线——AIME 2024 pass@1 从 15.6% 升到 71.0%(论文正文按 16 次采样取均值的口径;Figure 1a 曲线末点约 77.9%)。来源:论文[5] Figure 1a。
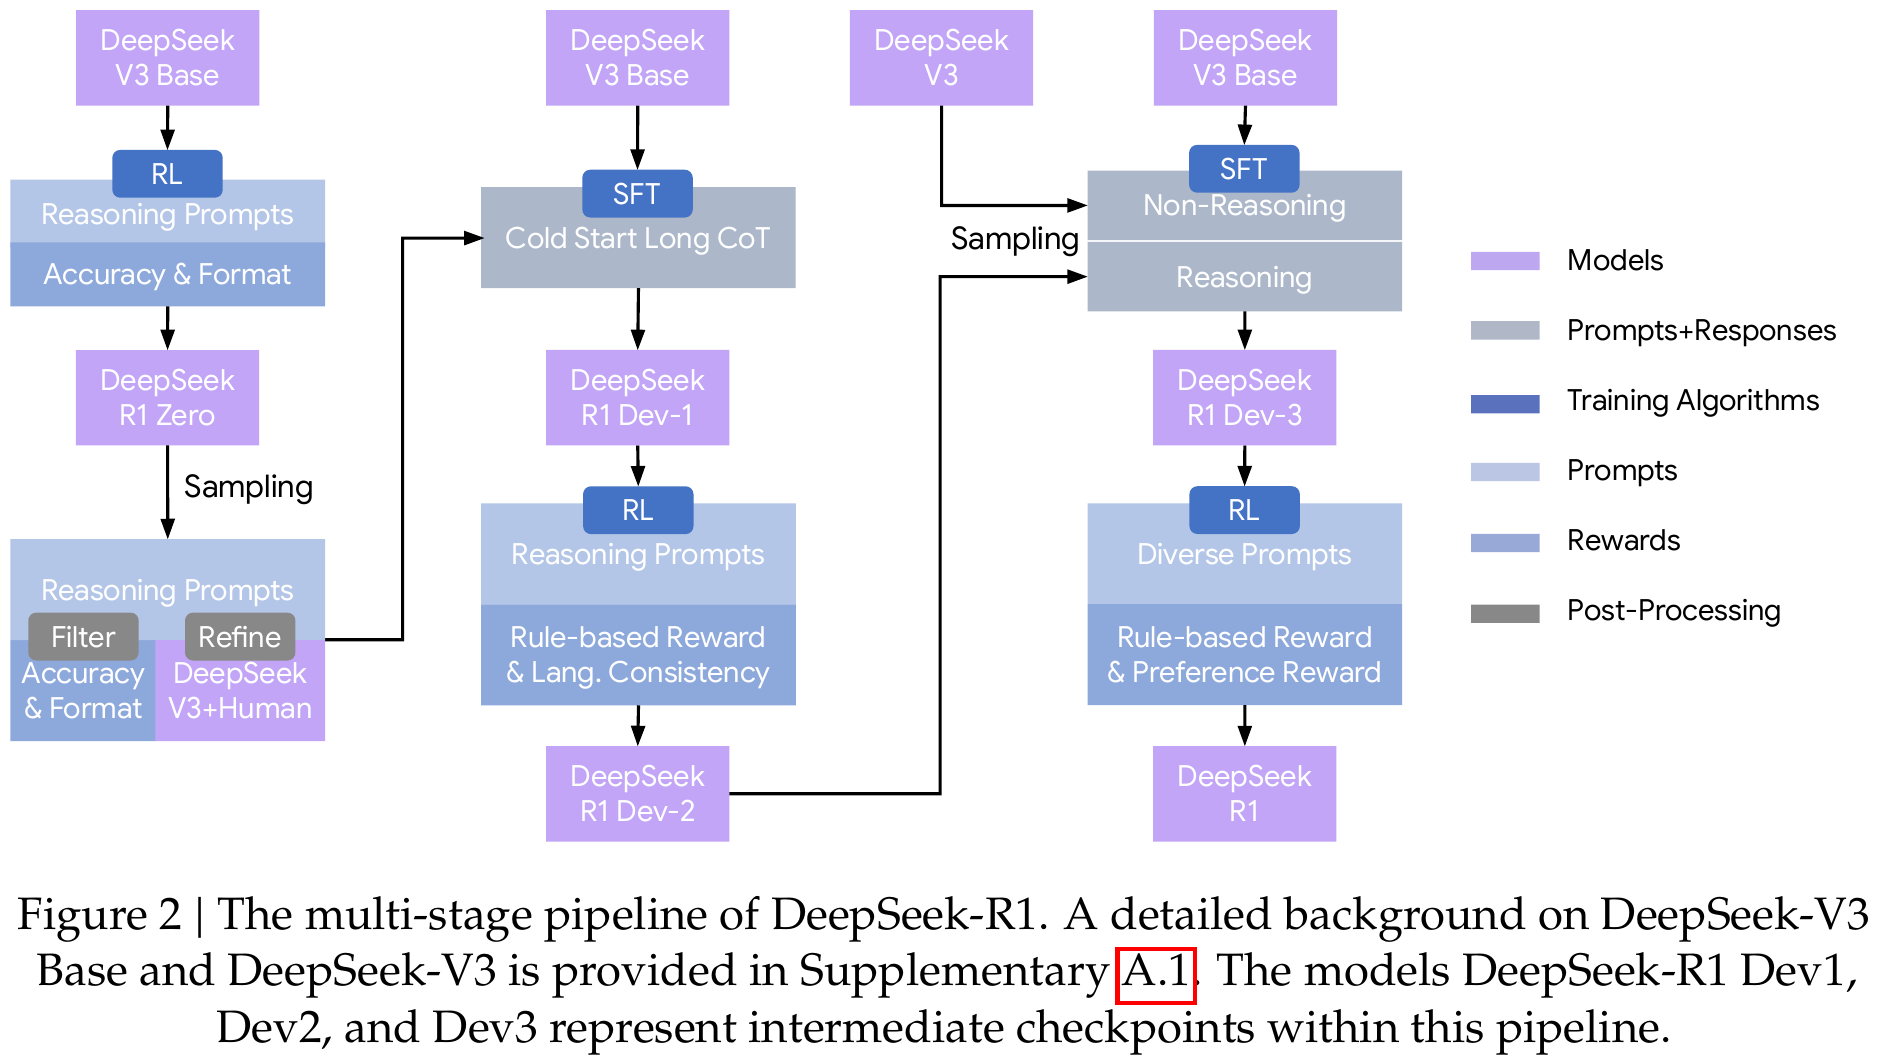
图 8:DeepSeek-R1 完整训练管线(R1-Zero → 冷启动数据 → 大规模 RL → SFT 与拒绝采样)。来源:论文[5] Figure 2。
证据(§4–§5)[5]:
- 涌现证据:R1-Zero 在 AIME 2024 上 pass@1 从 15.6% → 71.0%(论文正文口径;Figure 1a 的全程曲线末点约 77.9%);长 CoT、自我反思、策略自适应自发出现;
- 完整管线的主表:AIME 2024 79.8、MATH-500 97.3、LiveCodeBench 65.9、Codeforces percentile 96.3(rating 2029);
- 蒸馏:Qwen/Llama 多个 1.5B–70B 小模型用 R1 的 80 万条样本蒸馏,小模型反超自家 Instruct 版;
- 学术共同体验证:Nature 2025(DOI 10.1038/s41586-025-09422-z)[6]——一个工业 RL 训练产物走完同行评审,整除名与实现均公开。
7.1 R1 的能力怎么回到主线:蒸馏进 V3-0324,再回到 R1-0528
R1 的推理能力没有停在「一个」模型上,而是被蒸馏回主力线,形成两条并行[11][12]:
- V3-0324:卡片自述 MMLU-Pro 75.9→81.2、GPQA 59.1→68.4、AIME 39.6→59.4、LiveCodeBench 39.2→49.2,并称写作风格向 R1 对齐、代码可用性增强;
- R1-0528:推理深度与幻觉治理全面加强。
这步的意义:「专用强模型」变成了「通用主力模型的能力来源」。这和后来 V4 把能力来源扩展成「十多个教师」[9],是同一条方法论的两个版本。
7.2 Math-V2:奖励从「答案对不对」改成「过程可不可验证」
DeepSeekMath-V2 把目标从「答案对」推进到「过程可验证」:训练一个 faithful 的 LLM 定理证明验证器,自述在 IMO 2025 与 CMO 2024 达到 gold 水平、Putnam 2024 得 118/120(scaled test-time compute)[20]。
它不改主线的成本结构,但定义了 R1 之后「能力」怎么继续扩——从奖励答案,到奖励可验证的过程。
7.3 规则奖励 + GRPO:后训练底座从此换了
R1 之后,DeepSeek 的后训练长期沿用「规则奖励 + GRPO」:V3.2 的 Scalable RL 段仍是 GRPO 目标(加上 KeepRouting、Keep Sampling Mask、Off-Policy Sequence Masking 三个训练-推理一致性手段)[8];V4 的后训练两阶段里 RL 仍是域内强化手段,然后合并[9]。
8. V3.1(2025-08):一个模型两种模式,「想多久」变成一个开关
继承:V3 谱系。V3.1-Terminus 的 128K 权重是 V3.2 的起训 checkpoint[8]——这代基本不动架构,动的是能力与数据。
技术点一:混合思维(hybrid thinking)。一个模型通过 chat template 切换 thinking / non-thinking 两种模式,用户不需要在两个模型之间选。卡片自述 V3.1-Think 达到「与 R1-0528 相当的答案质量但更快」[10]。
技术点二:UE8M0 FP8 缩放格式。权重与激活的 FP8 scale 用 UE8M0(无尾数 8 位指数)格式,为后续 MX 类微缩格式打前站[10]。这是「训练硬件协同设计」的直接体现——和 V4 后面把 FP4 塞进 KV cache 是同一条线。
技术点三:长上下文数据扩容。卡片自述在 V3-Base 之上做两阶段扩展:32K 段数据量 ×10 到 630B tokens、128K 段 ×3.3 到 209B tokens[10]。注意:V3 时代长上下文靠的是「加数据」。
基准表(V3.1 卡片 Evaluation 段,四列列序已核对)[10][11][12]:
| Benchmark | V3.1-NonThinking | V3-0324 | V3.1-Thinking | R1-0528 |
|---|---|---|---|---|
| MMLU-Pro (EM) | 83.7 | 81.2 | 84.8 | 85.0 |
| GPQA-Diamond (Pass@1) | 74.9 | 68.4 | 80.1 | 81.0 |
| LiveCodeBench (Pass@1) | 56.4 | 43.0 | 74.8 | 73.3 |
| Codeforces-Div1 (Rating) | – | – | 2091 | 1930 |
| AIME 2024 (Pass@1) | 66.3 | 59.4 | 93.1 | 91.4 |
| AIME 2025 (Pass@1) | 49.8 | 51.3 | 88.4 | 87.5 |
混合思维可行且几乎不掉点(Thinking 列全面高于 NonThinking,且不逊于 R1-0528)。V4 系列把 effort 离散成三档(§10.4),V4.1-Flash 再把它做成 1–100 连续旋钮(§12)——「思考多少」这件事,从这代开始变成一个可编程的旋钮。
留下的成本:128K 窗口的 prefill 仍是 O(L²) FLOPs——注意力计算本身没变便宜,只是数据变多了。下一代要拆的就是「随长度增长项」本身。
9. V3.2(2025-12):长上下文的成本,第一次不随长度线性增长
从 V2 到 V3.1,长上下文成本一路靠 MLA + 加数据压;但注意力本身仍是 O(L²) FLOPs + O(L) 的 full-attention 计算:context 越长,prefill 越贵。这一代第一次让「算力随 token 位置增长」这件事趋平[8]。
9.1 NSA:把「看哪些 token」做成可学习的稀疏选择
NSA 论文提出可原生训练的稀疏注意力:动态层次稀疏 = 压缩分支(粗粒度 token 压缩)+ 选择分支(细粒度 top 块)+ 滑窗分支。两个关键点是算法侧算术强度均衡、实现侧与硬件对齐;64k 长度序列上解码、前向、反向均有加速(论文摘要口径)[7]。
NSA 当时没有进主干模型,但约 10 个月后 V3.2 的 DSA 与 V4 的 CSA 都是它的直系后代:
图 9:稀疏注意力演进链——NSA(研究先手)→ DSA(V3.2)→ CSA/HCA(V4)→ CSA2(V4.1-Flash)。
9.2 DSA 落进主干:V3.2-Exp 只改了这一处架构
V3.2 论文对架构改动的口径非常克制:唯一架构改动就是引入 DSA(DeepSeek Sparse Attention)[8]。
DSA 仍基于 MLA,但做了两件事。第一,给每个 query 加一个 lightning indexer:只用极少的头(论文口径:少量头、FP8 计算,索引开销接近零)算出一个索引分数,对每个历史 token 打分,然后按分数取 top-k 个 KV 位置——真正计算注意力时,只算被选中的那 k 个 KV。这就把 O(L²) 变成 O(L·k)。第二,索引器独立于主注意力单独训练,用一个 KL 损失让它「学得像主注意力怎么分布」,然后才放开全参数训练。
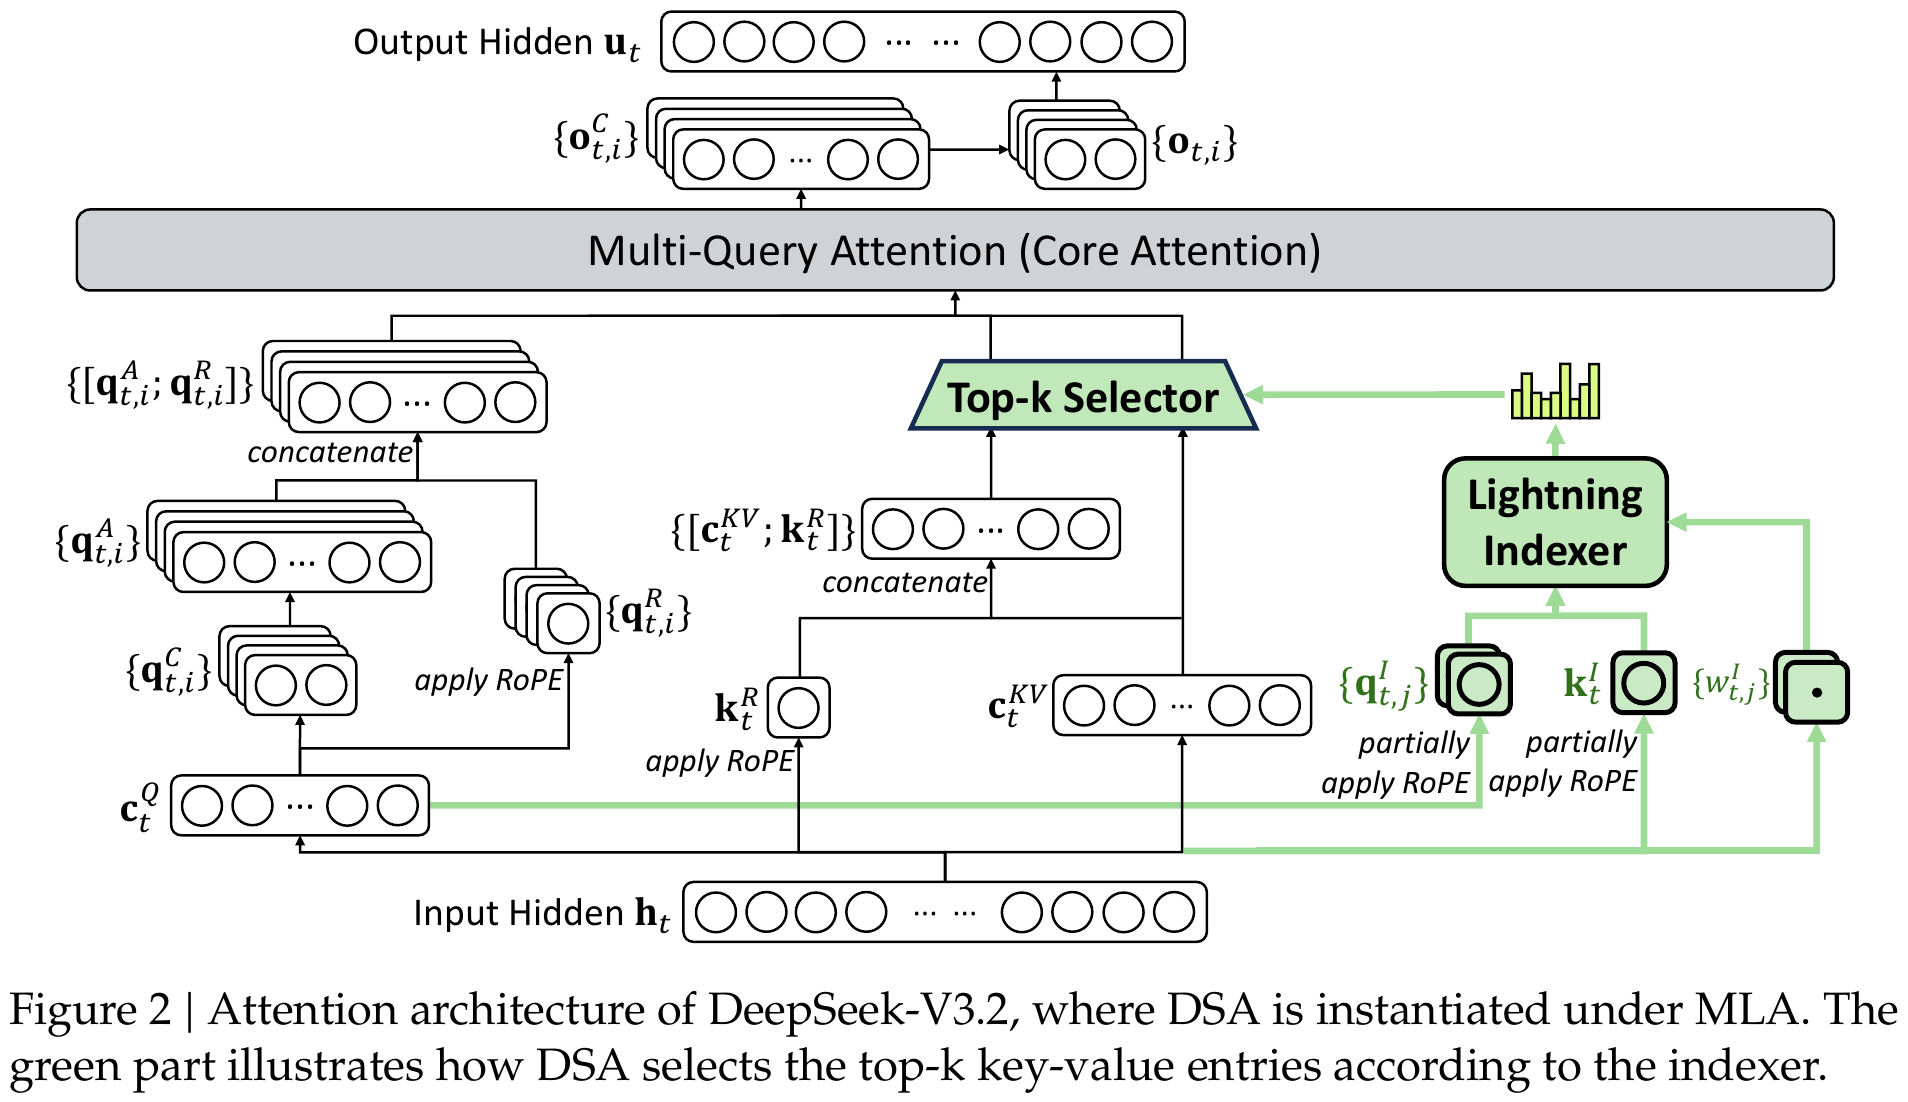
图 10:DSA 机制——MLA 潜向量之上加 lightning indexer 与 top-k 选择。来源:论文[8] Figure 2。
两阶段 continued pre-training 表(V3.2 论文 §2.3)[8]:
| 阶段 | 训练设置 | LR | top-k | 步数 × 批 × 长 | tokens |
|---|---|---|---|---|---|
| Dense Warm-up | 冻结全部主模型参数,只训 indexer | 1×10⁻³ | — | 1000 × 16×128K | 2.1B |
| Sparse Training | 全参数训练 | 7.3×10⁻⁶ | 2048 KV | 15000 × 480×128K | 943.7B |
warm-up 阶段先让索引器学会「像主注意力一样看」,再放开全参数训练——这是让稀疏不塌精度的关键工程。
证据(V3.2 论文 §3、Figure 3、Table 1)[8]:
- 论文在 H800($2/GPU-hour 租金假设)上测 token cost vs token position:128K 之后 V3.2 的成本曲线明显低于 V3.1-Terminus(短序列前向用 masked MHA 模式);
- 质量口径:论文 Table 1 给出 V3.2-Thinking 与 V3.1-Terminus 的逐项对比,结论是 sparse attention 未显著掉点(HLE 等少数项持平,多数项 V3.2 略优);
- 论文自述定位:「DeepSeek-V3.2 achieves similar performance with Kimi-k2-thinking and GPT-5 across multiple reasoning benchmarks」——开源档第一次与闭源前沿在这组基准上同档。
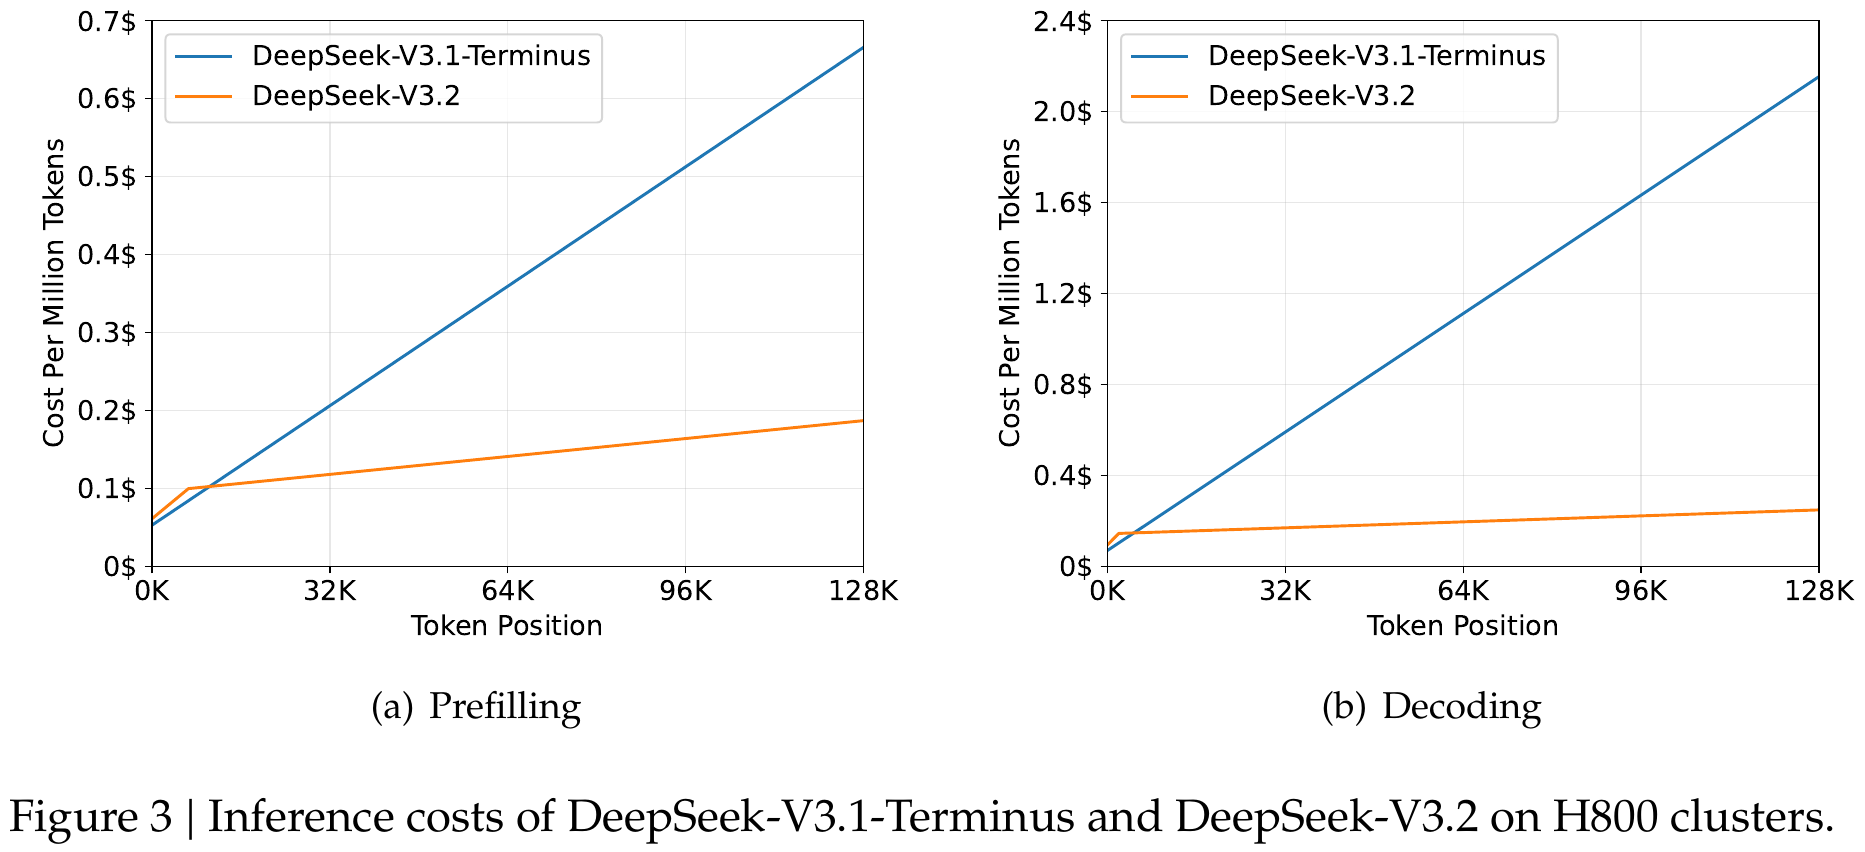
图 11:单 token 成本随上下文位置的变化——横轴至 128K,V3.2 的成本曲线在同等位置上低于 V3.1-Terminus。来源:论文[8] Figure 3。
9.3 后训练的三条线:RL 可扩展、agentic 数据、上下文管理
正式版 V3.2 在 DSA 之外主要是后训练升级,三条线都有论文口径[8]:
- Scalable RL:更多 GRPO 计算换更高上限,配套 KeepRouting / Keep Sampling Mask / Off-Policy Sequence Masking 三个训练-推理一致性手段;
- Agentic 任务合成:先做统一「推理 + 工具调用」单一轨迹的冷启动(沿用 V3 方法),再放大——论文口径「we generate over 1,800 distinct environments and 85,000 complex prompts」,用这批合成数据驱动 RL,显著增强复杂交互环境下的泛化与指令遵循;
- 通用任务的上下文管理:即便 128K 窗口,search 类 agent 仍会频繁顶到长度上限、让 test-time compute 提前截断。论文的解法是 prompt 侧的简单策略(token 用量超过窗口 80% 时触发):Summary(摘要后重启 rollout)、Discard-75%(丢掉前 75% 工具调用历史)、Discard-all(仿 Anthropic 的 new context 工具)。实测(BrowseComp):各策略在不同计算预算下都带来显著提升。
V3.2-Thinking 基准表(论文 §4.1 主表,列序已核对)[8]:
| Benchmark | Claude-4.5-Sonnet | GPT-5-High | Gemini-3.0-Pro | Kimi-K2-Thinking | MiniMax-M2-Thinking | DeepSeek-V3.2-Thinking |
|---|---|---|---|---|---|---|
| MMLU-Pro (EM) | 88.2 | 87.5 | 90.1 | 84.6 | 82.0 | 85.0 |
| GPQA Diamond (Pass@1) | 83.4 | 85.7 | 91.9 | 84.5 | 77.7 | 82.4 |
| HLE (Pass@1,仅文本子集) | 13.7 | 26.3 | 37.7 | 23.9 | 12.5 | 25.1 |
| LiveCodeBench (Pass@1-COT) | 64.0 | 84.5 | 90.7 | 82.6 | 83.0 | 83.3 |
| AIME 2025 (Pass@1) | 87.0 | 94.6 | 95.0 | 94.5 | 78.3 | 93.1 |
| Codeforces (Rating) | 1480 | 2537 | 2708 | – | – | 2386 |
| HMMT Feb 2025 (Pass@1) | 79.2 | 88.3 | 97.5 | 89.4 | – | 92.5 |
| HMMT Nov 2025 (Pass@1) | 81.7 | 89.2 | 93.3 | 89.2 | – | 90.2 |
思考预算量表(论文 §4.2,模型与产出 token 数)[8]:
| Benchmark | GPT-5-High | Gemini-3.0-Pro | Kimi-K2-Thinking | V3.2-Thinking | V3.2-Thinking-Speciale |
|---|---|---|---|---|---|
| AIME 2025 (Pass@1) | 94.6(13k) | 95.0(15k) | 94.5(24k) | 93.1(16k) | 96.0(23k) |
| HLE (Pass@1) | 26.3 | 37.7 | 23.9 | 25.1 | 30.6 |
| Codeforces (Rating) | 2537 | 2708 | – | 2386 | 2701 |
| GPQA Diamond (Pass@1) | 85.7 | 91.9 | 84.5 | 82.4 | 85.7 |
Speciale 用约 1.4 倍产出 token 换来 AIME +2.9、HLE +5.5、Codeforces +315:「给更多思考预算换更高上限」这条可量化的链,一路通到 V4 的三档模式和 V4.1-Flash 的 reasoning effort 1–100 连续参数。
继承关系(本节最重要):V3.2 用 DSA 验证了「索引 + top-k 稀疏」可以在不伤质量的前提下让成本不随 linear context 线性涨;V4 论文开篇即自述 V4 的注意力建立在 DSA 之上(保留其 lightning indexer + top-k 稀疏选择),但把「选谁」的对象从完整 KV 改成了压缩后的 KV——问题从「不要全部看」变成「先变小、再看着办」[9]。
留下的成本:稀疏省的是「看谁」,被看的 KV 条目本身还是全精度——条目本身还能再压。
10. V4(2026-04):注意力拆成压缩、稀疏、远看三条路,1M 上下文变便宜
V4 的模型卡副标题就是 One-Million-Token Context Intelligence。两件事:1M 上下文常规可用,而且方式是「结构性便宜」,不是「省着用」[9]。
主表(V4 论文摘要与 §4 配置)[9],V4-Flash 一列另可对官方模型卡[14]:
| 项目 | DeepSeek-V4-Pro | DeepSeek-V4-Flash |
|---|---|---|
| 总参数 / 激活 | 1.6T / 49B | 284B / 13B |
| Transformer 层 / hidden | 61 / 7168 | 43 / 4096 |
| 前两层 | HCA(重度压缩) | 纯 sliding window attention |
| 后续层 | CSA 与 HCA 交替(论文未给交替比例) | 同左 |
| 路由专家中间维 / 激活数 | 3072 / 6(1 共享 + 384 路由) | 2048 / 6(1 共享 + 256 路由) |
| MTP 深度 | 1 | 1 |
| mHC 扩展因子 / Sinkhorn 迭代次数 | 4 / 20 | 4 / 20 |
| 预训练 tokens | 33T | 32T |
| 序列长度扩展 | 4K → 16K → 64K → 1M | 同左 |
| 峰值批大小(tokens)/ 峰值学习率 | 94.4M / 2.0×10⁻⁴ | 75.5M / 2.7×10⁻⁴ |
| 推理精度 | FP4(MoE 专家)+ FP8(其余) | 同左 |
| 1M 上下文相对 V3.2 | FLOPs 27%、KV cache 10% | FLOPs 10%、KV cache 7% |
其余共享配置(两代相同,§4.2):CSA 压缩率 m=4、indexer query 头数 64、CSA top-k(Pro 1024 / Flash 512)、HCA 压缩率 m′=128、滑窗宽 128。
另有几项:所有块都是 MoE,但前 3 个 MoE 层用 Hash routing;MTP loss 权重 0.3,LR 衰减期起改为 0.1;偏置更新速度 0.001,balance loss 权重 10⁻⁴[9]。
10.1 CSA + HCA:压缩后精读,远距离粗看
V4 的注意力从「MLA 的逐头 K/V」改成 CSA(压缩稀疏)与 HCA(重度压缩)交替堆叠[9]:
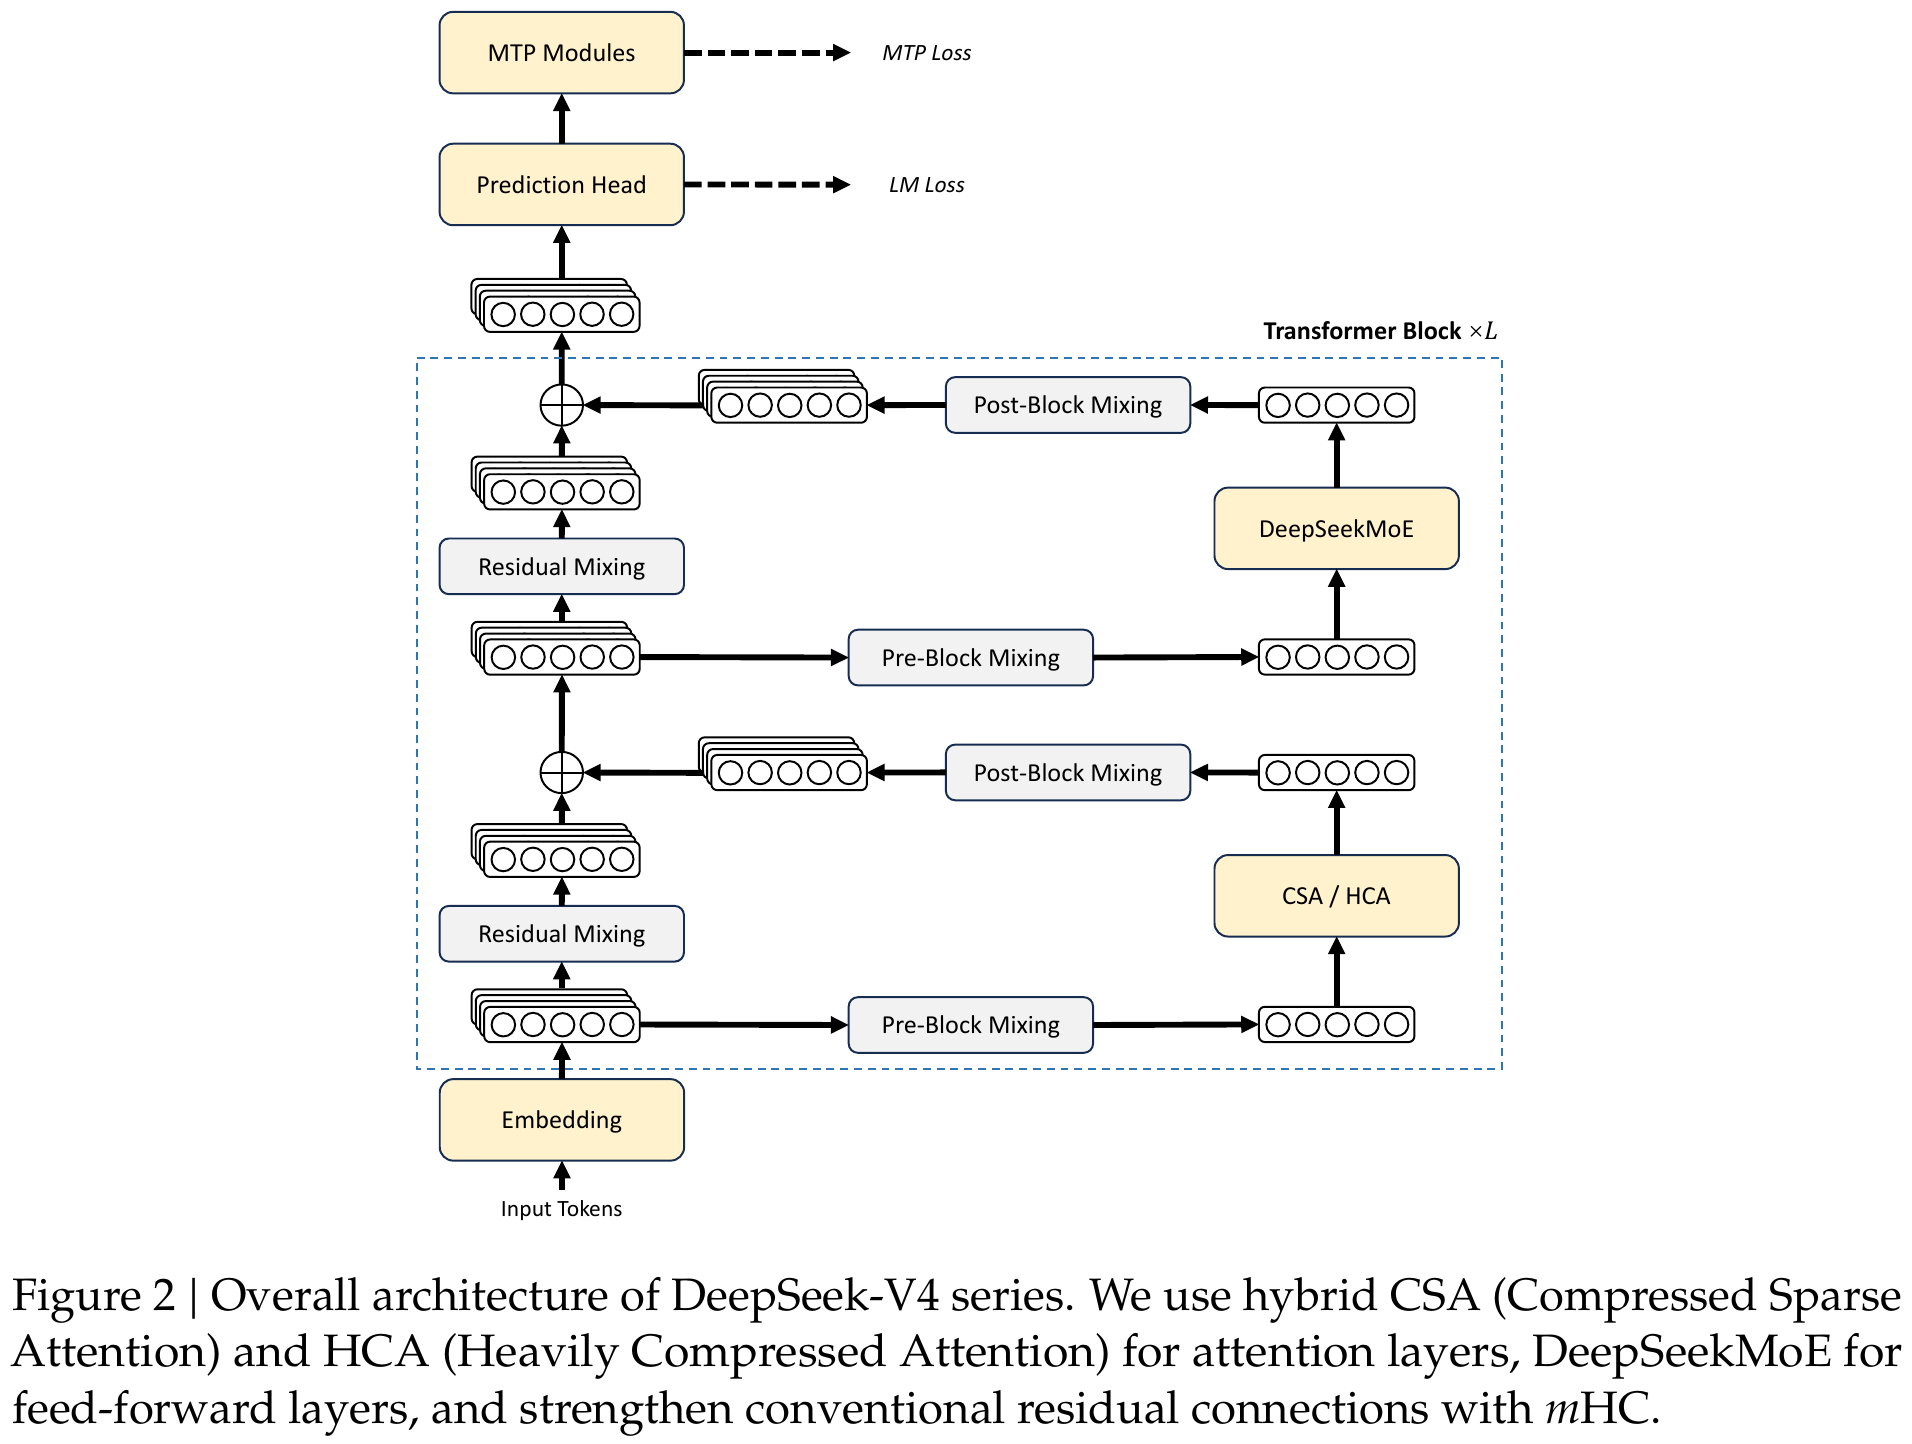
图 12:DeepSeek-V4 整体架构——看点是同一个 block 内 CSA 与 HCA 交替,输出端再分成 Prediction Head(LM Loss)与 MTP 模块两条支路。来源:论文[9] Figure 2。
- CSA(压缩稀疏):先把 m = 4 个 token 的 KV 压成一条条目,再跑 DSA 的 lightning indexer + top-k 选择(Pro 选 1024 条、Flash 选 512 条),最后附一小段 sliding-window KV(宽 128)保局部细节;core attention 是 Shared Key-Value MQA——每条压缩条目同时当 key 和 value。
- HCA(重度压缩):把 m′ = 128 个 token 压成一条 KV,不做 indexer/top-k,直接 dense attention。
- Shared KV 与消重边界:core attention 里每条压缩条目同时充当 key 与 value(shared KV MQA);论文同时写明两层障碍,使 KV cache 不能跨所有层合并。在此前提下叠加 query 侧稀疏,论文算出 V4-Pro 单 token KV ≈ GQA8 基线的 2%(1M 上下文设定)。
- partial RoPE:只对每 chunk 的最后 64 维加位置编码,输出侧按位置反向涂抹,让 core attention 输出携带相对位置。这是继 MLA 解耦 RoPE 之后的第二代位置编码工程。
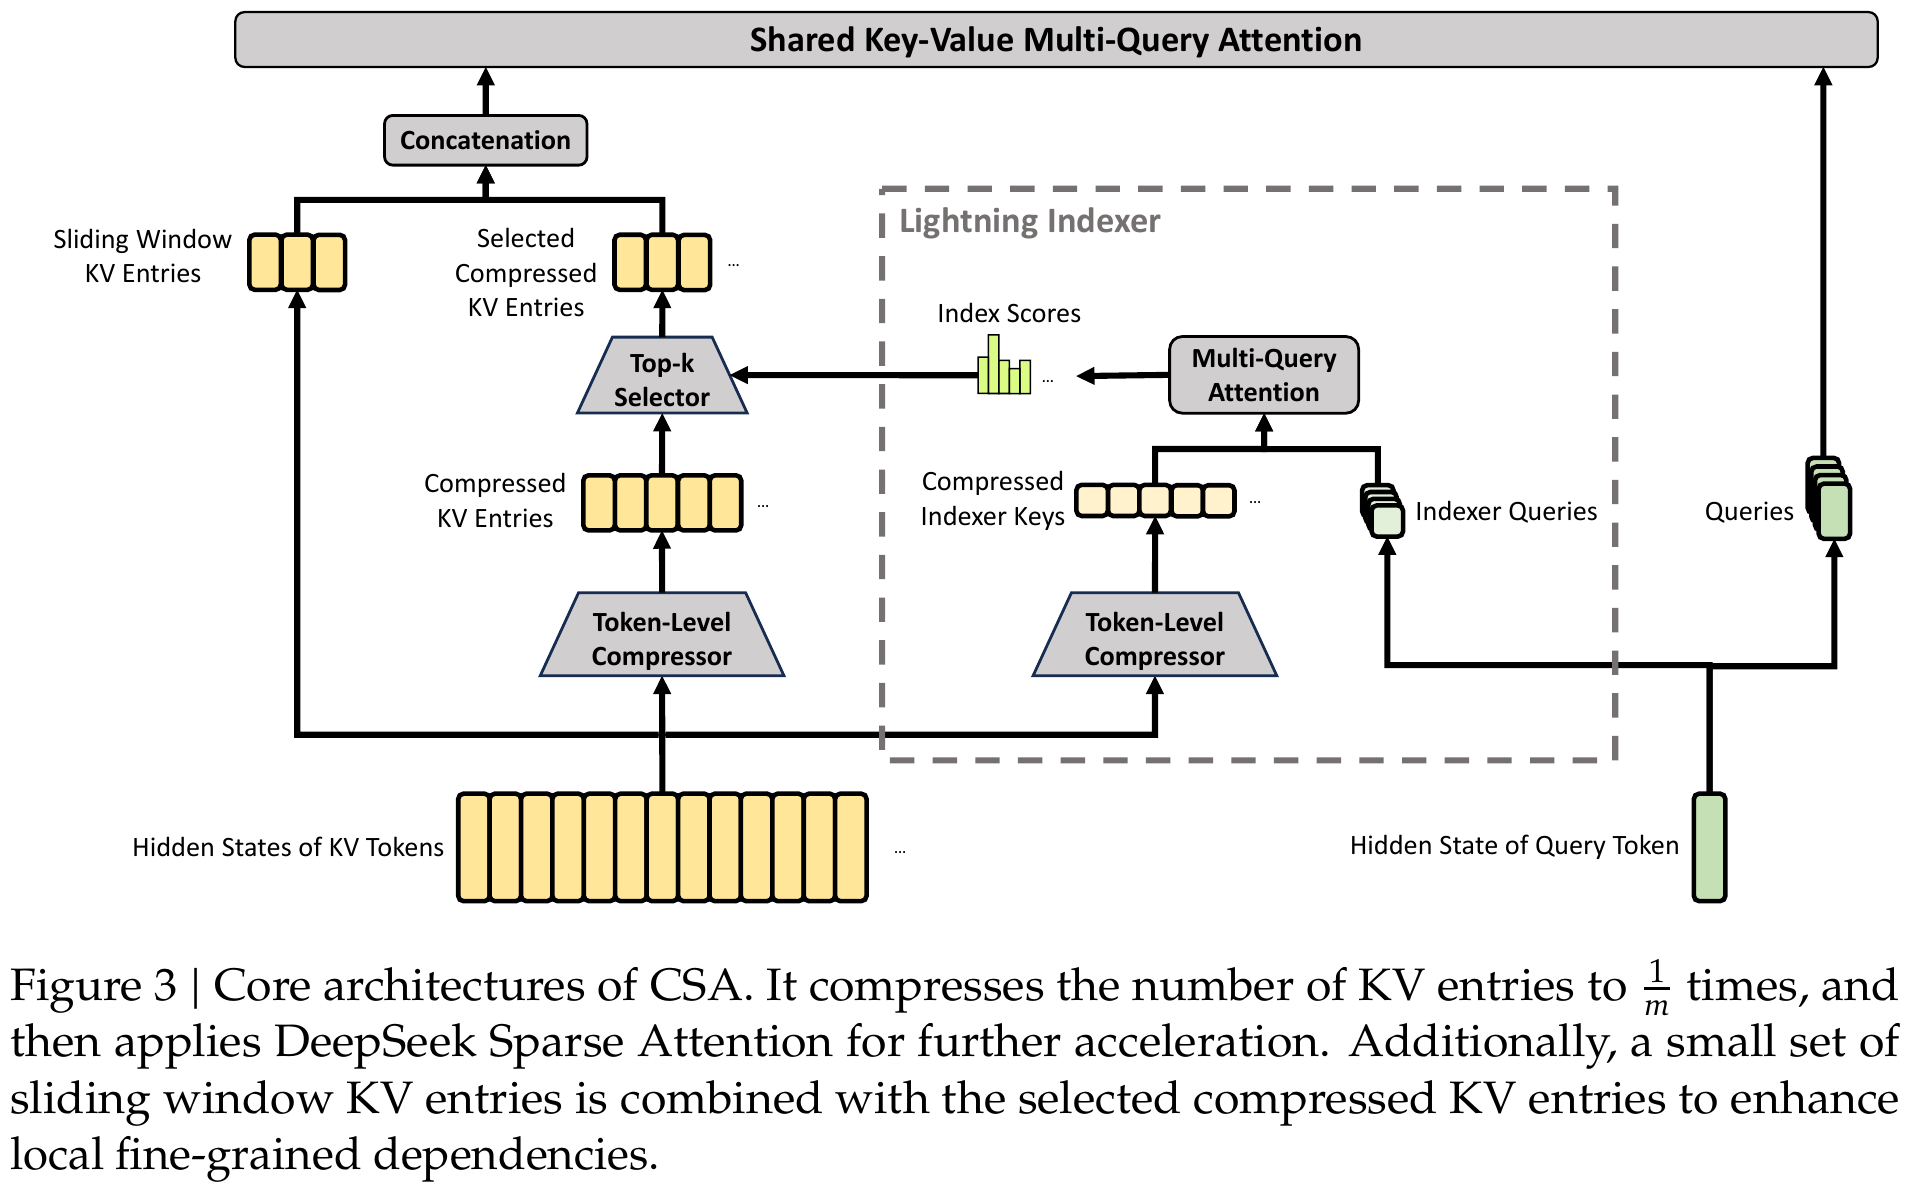
图 13:CSA/HCA 的压缩-稀疏注意力结构——看点是两条路径的分工:lightning indexer 只用少量压缩索引键算出 index scores,主路径据此 top-k 选出压缩 KV 条目,再拼一小段滑窗 KV 保局部细节;HCA 则省掉 indexer/top-k 直接 dense。来源:论文[9] Figure 3。
为什么这是演进而不是推倒重来:DSA 在 V4 论文里被公式级复用(Eq.15–17 与 V3.2 的 Eq.1–3 同形),V4 只是在它前面多压一层、把「看谁」的对象从完整 KV 改成压缩条目。论文 §2.3.1 自己写明了 CSA = DSA + KV 压缩的关系[9]。
V4 还刻意让压缩窗口「不含段边界」(取 m′ − 1 个中间块),以降低训练/推理不一致[9]。
10.2 mHC、Muon、Hash routing:训练侧换了三件,V4 自己也不稳
mHC(流形约束超连接):把残差连接升级为多路映射,并把残差映射矩阵约束在 Birkhoff 多面体上。这个多面体由「每行、每列的和都为 1 且元素非负」的矩阵组成,效果是把各层信号按比例重新分配(没有哪一路被放大),所以信号跨层的增益不会超过 1、不炸[9]。直觉上这是给深层残差流装一个「音量旋钮的上限」。
工程代价被论文量化:mHC 额外壁钟时间被压到「只有重叠 1F1B 流水线阶段的 6.7%」[9]。
Muon:大部分矩阵权重交给 Muon 优化器(动量 0.95、Nesterov、hybrid Newton-Schulz 迭代),AdamW 只留给 embeddings、prediction head、RMSNorm 与 mHC 偏置[9]。
Hash routing:前几层的 dense FFN 换成「按输入 token ID 预定义 hash 目标专家」的 MoE 层,把最不稳定的早期层路由变成确定性函数[9]。
「V4 也不稳」是这条线上最重要的一条证据。 V4 论文明写他们遇到了「notable instability challenges」——回滚只能暂缓、不能阻止 loss spike 复发;实证结论是 spike 与 MoE 层离群值一致出现,且路由机制本身会放大离群值。对策两招[9]:
- Anticipatory Routing:第 t 步用当前参数算特征、用历史参数计算并缓存路由索引,把 backbone 与路由网络的同步更新解耦。工程上在历史步预取数据、预计算并缓存索引,与 EP 通信流水化后,额外壁钟开销约 20%;
- SwiGLU Clamping:linear 分量 clamp 到 [−10, 10],gate 分量上界 10,直接压离群值。
对照看:V3 论文的「no irrecoverable loss spikes」在 1.6T 规模上失效了,V4 论文自己给出了成因、两条对策与可复现条件。规模换来的不只是能力,还有新的失效模式——这是全篇最诚实的一段。
10.3 基础设施:把 1M 上下文的显存账算平
| 技术 | 机制 | 论文量化结果 |
|---|---|---|
| Expert 并行(EP) | 分波重叠 Dispatch / Linear-1 / Linear-2 / Combine | 理论上限 1.42×(Comet)→ 1.92×(Fig.5);V4-Pro 满足 C/B ≤ 6144 FLOPs/Byte,即每 GBps 互联带宽可隐藏 6.1 TFLOP/s 通信 |
| CP(上下文并行) | 两阶段通信:rank 间先传 m 个未压缩 KV,再 all-gather + fused select-and-pad | 论文只给机制描述、未给加速比(split-K 恰因不能保 batch 不变性而被放弃,见下行) |
| TileLang + Z3 | 把 kernel 里的整数表达式转成 Z3 可判定形式(QF_NIA + ILP),服务于布局推断、内存冒险检测、边界分析等编译 pass | 消除「重排 kernel 导致数值漂移」这类最贵的 bug |
| Batch-invariant 解码 | attention 为保 batch 不变性不能用 split-KV → 自研双内核:核①整序列在单 SM 内算满波,核②多 SM 分摊收尾残波,但累加顺序与核①逐位一致 | 解码输出可按 batch 位置 bitwise 复现,同时不倒退 wave quantization |
| Muon/mHC/并行重设计 | warp specialization、通信-计算流水化 | mHC 开销 6.7%、Anticipatory Routing ~20% |
出自 V4 论文 §3.3–3.5 与 §4.2[9]。主题一句话:用编译器与形式化手段,把「新架构能不能稳定跑大规模」变成可证明、可复现的工程问题。
10.4 OPD 取代混合 RL:后训练只剩一条主线
V4 论文 §5 的后训练是两段:domain-specific post-training(SFT + GRPO)→ unified model consolidation。第二阶段用 On-Policy Distillation(OPD) 把多个域专家的能力合并成一个模型[9]。
机制用一句话说清:学生模型自己采样轨迹,十多个教师在这同一条轨迹上逐 token 给出自己的分布,用加权 KL 距离(reverse KL)把学生拉向教师群的加权中心。相比 V3.2 时代的「specialist distillation + mixed RL」,整段被替换[9]。
派生件:Quick Instruction tokens(短文快速指令格式)、DSec 沙箱(Rust 组件组成的生产级执行/评测沙箱)、三种 reasoning 模式(Non-Think / Think High / Think Max,见 V4-Pro 模型卡)[13]。
10.5 V4 基准:哪些数字可信,哪些只是官方自比
Base Model(V4-Pro 模型卡,三列同设置)[13]:
| Benchmark | V3.2-Base | V4-Flash-Base | V4-Pro-Base |
|---|---|---|---|
| # 激活参数 / # 总参数 | 37B / 671B | 13B / 284B | 49B / 1.6T |
| MMLU-Pro (EM) 5-shot | 65.5 | 68.3 | 73.5 |
| SuperGPQA (EM) 5-shot | 45.0 | 46.5 | 53.9 |
| Simple-QA verified (EM) 25-shot | 28.3 | 30.1 | 55.2 |
| FACTS Parametric (EM) 25-shot | 27.1 | 33.9 | 62.6 |
| HumanEval (Pass@1) | 62.8 | 69.5 | 76.8 |
| LongBench-V2 (EM) | 40.2 | 44.7 | 51.5 |
Instruct(V4-Pro-Max vs 前沿,max effort,节选;六列列序与卡片一致)[13]:
| Benchmark | Opus-4.6 Max | GPT-5.4 xHigh | Gemini-3.1-Pro High | K2.6 Thinking | GLM-5.1 Thinking | DS-V4-Pro Max |
|---|---|---|---|---|---|---|
| MMLU-Pro (EM) | 89.1 | 87.5 | 91.0 | 87.1 | 86.0 | 87.5 |
| GPQA Diamond (Pass@1) | 91.3 | 93.0 | 94.3 | 90.5 | 86.2 | 90.1 |
| HLE (Pass@1) | 40.0 | 39.8 | 44.4 | 36.4 | 34.7 | 37.7 |
| LiveCodeBench (Pass@1) | 88.8 | – | 91.7 | 89.6 | – | 93.5 |
| Codeforces (Rating) | – | 3168 | 3052 | – | – | 3206 |
| MRCR 1M (MMR) | 92.9 | – | 76.3 | – | – | 83.5 |
| Terminal Bench 2.0 (Acc) | 65.4 | 75.1 | 68.5 | 66.7 | 63.5 | 67.9 |
| SWE Verified (Resolved) | 80.8 | – | 80.6 | 80.2 | – | 80.6 |
论文与卡片对 V4-Pro-Max 的自我口径是「redefines the state-of-the-art for open models」;同时表里 Opus / GPT-5.4 / Gemini 在若干项(MMLU-Pro、HLE、MRCR、Terminal Bench 2.0)仍领先。
但更有价值的是 V4 论文对自己位置的判断——原文写在结论里[9]:
its performance falls marginally short of GPT-5.4 and Gemini-3.1-Pro, suggesting a developmental trajectory that trails state-of-the-art frontier models by approximately 3 to 6 months
这句话比任何形容词都更能定位 V4 系列:在知识与推理基准上,DeepSeek 自评落后闭源前沿约 3–6 个月;而在 LiveCodeBench(93.5)、Codeforces(3206)等代码/竞赛项上它反而是当期最高。 一边是最性价,一边还差半年——这条张力一直延续到 V4.1-Flash。
11. 2026 年中期三次小版本:只调数据与解码,不动结构
预览版到正式版,架构没变,变的是数据与解码:
-
V4-Pro-0813 / V4-Flash-0731:官方正式版,结构、上下文、精度全部不变,增强点在 agentic 后训练数据。同一张官方对比表内的跃升非常说明问题[15][16]:
版本跃升(同表同框架) 预览 正式版 DeepSWE:V4-Pro 12.8 62.7(0813) DeepSWE:V4-Flash 7.3 54.4(0731) Terminal-Bench 2.1:V4-Pro 72.1 87.9(0813) Terminal-Bench 2.1:V4-Flash 61.8 82.7(0731) 这些数字同表、同框架(DeepSeek Harness minimal 模式、max effort、temperature=1.0);预览版与正式版的差距既有后训练因素,也有 agent scaffold 成熟度因素,只认「表内可比」,不做归因断言。
-
DSpark:不是新模型,是附加在同一 checkpoint 上的投机解码模块——半自回归草稿生成 + 置信度调度校验。V4-Flash-0731 模型结构自述「与 V4-Flash-DSpark 相同」,实现开源在
github.com/deepseek-ai/DeepSpec[16][17][21]。这是 MTP 思想的部署级延伸:V3 用 MTP 做训练/推理加速,V4 时代固化成可插拔轨件。 -
V4-Flash-Vision-Exp:首个多模态实验版,在 V4-Flash 上加视觉模块续训;卡片自述对纯文本 agent 任务影响 comparable[18]。
12. V4.1-Flash(2026-09):每 token 的 KV 只剩 890 字节,成本从「记忆」转到「思考」
V4.1-Flash 模型卡的小标题就是「Pushing the Limits of KV Cache Compression」[19]。到这一步,核心矛盾已经换了:agent 负载输入远重于输出,KV 从「推理副产物」变成「主要成本项」。
这一代五件事[19]:
| 变化 | 机制 | 量化结果 |
|---|---|---|
| CED 编码器-解码器 | 40 层 = 20 层因果编码器 + 20 层解码器;解码器全局 KV 由编码器末层 hidden 投影而来,而非每层自产 | 单 token 激活:prefill 8B、decode 16B |
| CSA2 | 每层从 Full / Reindex / Reuse 三种静态模式中选一,跨层共享 main KV 与 indexer K、复用 top-k 索引;解码器加 Hierarchical Sparse Indexer(深层索引只在第一层 Full 模式给出的候选池里挑) | 深层 indexer 成本与上下文长度解耦 |
| FP4 main KV | E2M1 格式,每 16 通道一个 E4M3 缩放 | 890 字节/token ≈ V4-Flash 的 1/4 |
| SWA Bounded Replay | 只回放最近 n_win 个 token 重建滑窗 KV,不持久化到 SSD | 持久 KV 足迹 ≈ V4-Flash 的 1/8 |
| Mega-mHC + Engram | 单遍 mHC 内核;Engram = 196B 参数的稀疏查表条件记忆 | backbone 552B(另有 196B Engram);预训练 45T tokens;稀疏注意力自 64K 起训、34T tokens 处扩到 1M |
图 14:V4.1-Flash 结构——CED 编码器-解码器、CSA2 三种模式、FP4 main KV。
训练/后训练口径:从头训练 45T tokens,视觉(DeepSeek-ViT,2D-RoPE + 3×3 pixel-unshuffle)从预训练第一刻与文本同流;后训练沿用 SFT → RL → OPD,无算法改动,实质变化在数据管道;每层 1 共享 + 384 路由专家、每 token 激活 6 个[19]。
把 KV 足迹这条线串起来(数字汇总,口径逐条标注):
模型卡自评降幅:相对 DeepSeek-V4-Flash 约 4 倍;相对初代 DeepSeek-V1 约 437 倍(卡片 Figure 1(b) 与图注,两个基准都是卡片自报)[19]。
基准表(V4.1-Flash 模型卡,max reasoning effort,列序与卡片一致;完整表见卡片)[19]:
| Benchmark (Metric) | Opus-5.0 | GPT-5.6 Sol | K3 | GLM-5.3 | DS-V4-Pro | DS-V4-Flash | DS-V4.1-Flash |
|---|---|---|---|---|---|---|---|
| GPQA Diamond (Pass@1) | 93.4 | 94.1 | 92.9 | 88.1 | 92.4 | 89.9 | 90.9 |
| HLE (Pass@1) | 56.3 | 44.5 | 43.5 | 42.0† | 42.7† | 37.8† | 36.8(39.1†) |
| Codeforces (Rating) | – | – | – | – | 3348 | 3289 | 3471 |
| MathArena Apex (Pass@1) | – | – | 65.6 | – | 65.3 | 58.6 | 65.6 |
| Terminal-Bench 2.1 (Pass@1) | 89.1 | 88.8 | 88.3 | 88.2 | 87.9 | 82.7 | 90.6 |
| Terminal-Bench 3.0 (Pass@1) | 43.3 | 34.4 | 17.7 | 28.3 | 11.8 | 7.6 | 30.0 |
| Terminal-Bench 4.0 (Pass@1) | 51.8 | 39.9 | 12.6 | 37.9 | 12.4 | 7.0 | 31.2 |
| DeepSWE v1.1 (Resolved) | 74.0 | 73.0 | 67.5 | 66.9 | 62.7 | 54.4 | 74.2 |
| NL2Repo-Bench (Score) | 75.3 | 56.8 | 58.0 | 58.0 | 61.5 | 54.2 | 64.0 |
| CyberGym (Pass@1) | – | 84.5 | 80.0 | 84.5 | 83.3 | 76.7 | 88.1 |
| HLE w/ tools (Pass@1) | 63.6 | – | 59.8 | 62.5 | 60.0 | 51.5 | 63.9 |
| MMMU-Pro (EM) ‡ | – | – | – | – | – | – | 56.5 |
| CVBench (EM) ‡ | – | – | – | – | – | – | 77.9 |
| DocVQA (LLM-Judge) ‡ | – | – | – | – | – | – | 95.6 |
| RefCOCO-avg (Acc@0.5) ‡ | – | – | – | – | – | – | 86.0 |
† HLE 仅文本子集。‡ 多模态四项(MMMU-Pro 起)为 V4.1-Flash 独有项,且出自卡片 Base 模型表(4-shot / 0-shot 口径),与本表其余行的 instruct「max reasoning effort」设置不同,不可直接比较。
Reasoning effort 1–100:思考预算成为连续整数旋钮(1–100),显式 trading inference cost for accuracy;表中所有 instruct 数字用 reasoning_effort=100。这是 V3.2-Speciale「更多产出 token 换更高分」和 V4 三模式的统一可编程化[19]。
scaffold 敏感性(同一个 V4.1-Flash、不同 agent 框架,N=8)[19]:
| 框架 | DeepSWE v1.1 |
|---|---|
| Claude Code | 69.8 |
| Codex | 65.6 |
| DSH Minimal | 72.6 |
| DSH Standard | 70.5 |
换 scaffold 的波动(DSH Minimal 72.6 vs Codex 65.6,7 个点)不小,但仍小于同表内换一代模型的差距(同卡片 DeepSWE v1.1:V4-Pro 62.7 → V4.1-Flash 74.2,11.5 点)。到这一步,「模型演进」已经不是单条曲线,而是模型 × 上下文工程 × agent scaffold 的三元函数。
13. V4.1-Flash-1017(2026-10-17):结构没动,那条判据第一次不用交换
前九次发布,凡是换结构的,都要在「省资源」和「不掉点」之间做一次交换。第十次没有换结构:模型卡第一句称它是 V4.1-Flash 的 minor update[22],官方发布说明的措辞是「更强、更快、输出更短——一次性能与成本的帕累托改进」[23]。
同结构,两样同时拿到。跑了两年多的判据,第一次不需要做选择。
基准表(V4.1-Flash-1017 模型卡,列序与卡片一致)[22]:
| Benchmark | DS-V4.1-Flash-1017 | DS-V4.1-Flash | K3 | GLM-5.3 | GPT-5.6 Sol | Opus 5 |
|---|---|---|---|---|---|---|
| HLE w/o tools | 42.6(44.0†) | 36.8(39.1†) | 43.5 | 42.0† | 44.5 | 56.3 |
| Terminal-Bench 4.0 | 42.3 | 31.2 | 12.6 | 37.9 | 39.9 | 51.8 |
| DeepSWE v1.1 | 77.0 | 74.2 | 67.5 | 66.9 | 73.0 | 74.0 |
| ProgramBench | 29.1 | 20.3 | 17.5 | 19.0 | 23.0 | 37.0 |
| NL2Repo-Bench | 68.2 | 65.4 | 58.0 | 58.0 | 56.8 | 75.3 |
| Automation-Bench v1.0.6 | 60.5 | 54.8 | 46.7 | 48.8 | 45.8 | 50.3 |
| Agents’ Last Exam | 35.4 | 31.8 | 27.6 | 28.5 | 26.7 | 28.6 |
| Apex Bench v1.1 | 72.1 | 64.6 | 47.8 | 56.6 | 54.3 | 65.8 |
| Chartography (w/tools) | 83.0 | 78.9 | 68.1 | – | 79.9 | 84.0 |
| BabyVision (w/tools) | 92.5 | 89.6 | 85.7 | – | 88.9 | 94.1 |
| ZeroBench-main (w/tools) | 51.0 | 49.0 | 41.0 | – | 53.0 | 52.0 |
† 仅 HLE 取文本子集;Terminal-Bench 4.0 用 Claude Code 框架、DeepSWE v1.1 用 Mini-SWE-V2 框架[22]。
13.1 涨点涨在「任务」,不在「知识」
表里没有 GPQA。涨得最多的是长任务与工程任务:Terminal-Bench 4.0 从 31.2 到 42.3(+11.1)、ProgramBench 20.3→29.1(+8.8)、Apex Bench 64.6→72.1(+7.5)、Automation-Bench 54.8→60.5(+5.7)、HLE 36.8→42.6(+5.8)[22]。官方把这条增量归给基于自反馈的强化学习——先跑出结果、看结果、再改,能力覆盖到从零建完整项目(游戏、3D 建模)[23]。
这解释了为什么涨在任务侧:这类基准量的不是「知道多少」,是「能不能把一件事推到最后」;而「自己检查、自己改」正是后训练里新加的那一环。
13.2 省的是输出与墙钟,不是显存
官方同时给了两条下降:任务运行时间与输出长度;DeepSWE 还被画成一张 Pass@1 对「每任务成本」的曲线[23]。选这条路径有价格上的依据:按 2026-10 的价目表,Flash 的输出 token 单价是缓存命中 token 的 200 倍($0.6 对 $0.003,每百万 token,低谷价)[24]。KV 已经压到 890 字节,再压它的边际收益越来越薄;而被省下来的每一个输出 token,值 200 个缓存 token。
「便宜的东西继续变便宜」和「贵的东西变少」在账上不是一个量级。1017 是这条主线里第一次把刀落在后者。
13.3 把「脚手架」写进了发布说明
模型卡注明 Terminal-Bench 4.0 用 Claude Code、DeepSWE 用 Mini-SWE-V2[22];官方另点名针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 做了优化,并给出最低版本号[23]。§12 里「模型 × 上下文工程 × scaffold」还是观察,到这里成了发布说明的一部分。
对做选型的人还有两条实用信息:deepseek-flash 背后的权重已换成 1017,旧名 deepseek-v4-flash 仍可调用、但由新模型提供服务并按 Flash 价计费;上下文 1M、最大输出 384K 不变[24]。Search 与 Fetch 两个接口随这版开放,按请求计费(每个接口 $0.75/千次)[23]——当 KV 便宜到可以忽略,成本就继续往外挪,挪到「调用了几次工具」上。
13.4 九天后,上一版「下一个战场在 effort 旋钮」的预测兑现了一半
10-08 那版在结尾写:「下一步的分水岭是谁能把 effort 旋钮做得更可预期。」1017 给了半个答案,方向却不在「更准的旋钮」:它把运行时间和输出长度一起压短,用户不去碰 effort 也能少付。可预期性那一半还空着——「再多想 20 步,能多换到什么」,今天仍然要自己试。
于是两条线第一次分了岔:结构线停在 890 字节,能力线还在往上走。这也是 1017 最不像「新模型」、又最值得记住的地方——当结构没什么可换的时候,被换掉的就轮到「想」本身的开销了。
14. 两条线:KV 足迹降了约 280 倍,能力从 RL 涌现走到 effort 旋钮
把八代(+旁支)和一次同代更新叠在一起看,是两条线。线本身平滑,但有三个转折点值得单独标出来。
第一次是 V2 的 MLA:它把推理成本从”模型选型的副产物”变成一等公民,此后每一代都要先回答”KV 怎么放”。第二次是 R1 的规则奖励:能力可以不靠人工写过程获得,后训练的底座从此换了。
第三次是 V3.2-Exp 的 DSA:它把”看谁”的成本从随长度线性增长里拆出来,长上下文第一次有了可持续的价格。
图 15:左——每 token KV cache 足迹从约 249 KB(GQA8 基线)降到 890 字节,跨度是 2024-05 的 V2 到 2026-09 的 V4.1-Flash(约两年半);右——DeepSWE v1.1 能力(官方卡片口径,只画到 V4.1-Flash;1017 的 77.0 见 §13 表)。
KV 足迹线(统一按 bf16、同一 GQA8 基线折算,避免混基准):GQA8 基线 ≈ 249 KB/token → MLA ≈ 70 KB/token(约 1/3.6)→ V4:1M 上下文 KV 为 GQA8 的约 2%(论文口径)→ V4.1-Flash 890 B/token[19]。另:V2 论文自报相对 DeepSeek 67B 的 KV cache −93.3%,那是另一套基准,不参与这条折算链[3]。每一步都不是「省着用」,而是换结构:潜向量 → 先压缩再稀疏 → 条目共享 → 量化 → 编码器-解码器。近三年里换了五种结构,才把这条线压下去约 280 倍(两个多数量级)。
推理范式线:R1 的纯 RL 涌现 → V3-0324 蒸馏 → R1-0528 deep thinking → V3.1 混合思维 → V3.2 scalable RL + Speciale 思考预算 → V4 三模式 + OPD → V4.1-Flash 连续 effort 1–100 → V4.1-Flash-1017 不改结构、只压输出与运行时间;旁线是 Math-V2 把「可验证」引入奖励[5][8][9][10][11][12][19][20][22][23]。
两条线在 1017 这里分岔。结构线停在 890 字节,成本却按旧规律又转移了一次——从「记忆」转到「思考」之后,再转到「输出」。V4.1-Flash 的产品设计是 effort 旋钮,1017 把默认路径压短,等于把旋钮之外那层开销也摆上了台面:用户不拨的时候,模型也不必把话说满。这也是读这条主线最能得到启发的地方:一次成功的成本优化不会结束问题,它会把问题推到下一个更值钱的地方。
15. 下一站:effort 旋钮、过程奖励,以及模型之外的脚手架
读完整条线,好用的不是「DeepSeek 现在多强」,而是它给出的一个可预期的下一步。如果「成本会从便宜的地方转移到更贵的地方」这条规律继续成立,那么接下来最值得盯的是三件事。
一、effort 旋钮剩下的那一半是可预期性。V4.1-Flash 把思考预算做成 1–100 的连续整数,1017 又把默认路径压短了(§13.4)——能省的那一轮已经省过。下一步的分水岭不是把旋钮做得更细,而是让用户事先知道「再多想 20 步,能多换到什么」:一条可查的收益曲线,比一个 1–100 的整数更难做,也更有用。
二、奖励会继续从「答案」走向「过程」。 R1 用规则奖励证明了「不教过程也能涌现过程」;Math-V2 则把可验证性直接写进奖励(训练一个 faithful 的定理证明验证器)。这条线走下去,下一个成本项可能是验证:不是让模型想得更久,而是让它的每一步都能被便宜地检查。
三、「模型」这个词会继续被稀释。 V4.1-Flash 的 scaffold 敏感性说明,最终分数是 模型 × 上下文工程 × agent scaffold 的三元函数——同一个模型换框架,DeepSWE 波动可达 7 个点,与部分代际差距同量级;1017 干脆把 DSH、CodeBuddy、WorkBuddy 写进发布说明,厂商开始按框架调模型(§13.3)。这意味着成本优化的下一个战场未必在模型内部:脚手架与上下文策略里,还压着没被拆过的成本项。
还有一件确定性很高的事:规模会继续带来新的失效模式。 V3 的「无不可恢复尖峰」在 1.6T 上失效,V4 自己给出了成因、两条对策与可复现条件。所以往上再走一层,同类事情大概率还会重演。这也是全篇最值得带走的方法论——先测量,再选对要减的那个量,优化后重测。技术点会过时,这个顺序不会。
口径与边界:哪些数字是官方自报,哪些是折算值
说清可信度边界,便于判断哪些能直接用:所有数字均为论文/模型卡自报口径,未独立复测;表内跨模型对比也是官方自比(同一评测协议下的官方口径),不构成第三方基准。
1017 同此:它是同架构的后训练更新,「输出长度与运行时间缩短」官方只给了方向与曲线,没有给具体百分比;§13 的 200 倍按 2026-10-18 的官方价目表低谷价折算,价格随官方调整[24]。其余推算是按论文配置折算的——MLA 的 70 KB/token、GQA8 基线的 ≈249 KB/token、V4-Flash 的 ≈3.6 KB/token(由「890 B ≈ 1/4」折得);模型卡另给的「437 倍」是其 Figure 1(b) 相对初代 DeepSeek-V1 的自报口径。
代际划分与机制谱系归并(NSA→DSA→CSA、V3 无辅助损失→V4 anticipatory routing 等)是一种呈现方式,非官方分类;预览版到正式版的 benchmark 跃升只认同表可比,不做归因断言。
所以读到新版本时,先分清它动的是哪一层:结构、后训练,还是脚手架。三层的性价比不在一个量级,判断顺序也不该一样。
参考文献
[1] DeepSeek-AI. DeepSeek LLM: Scaling Open-Source Language Models with Longtermism. arXiv:2401.02954, 2024. https://arxiv.org/abs/2401.02954
[2] DeepSeek-AI. DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models. arXiv:2401.06066, 2024. https://arxiv.org/abs/2401.06066
[3] DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. arXiv:2405.04434, 2024. https://arxiv.org/abs/2405.04434
[4] DeepSeek-AI. DeepSeek-V3 Technical Report. arXiv:2412.19437, 2024. https://arxiv.org/abs/2412.19437
[5] DeepSeek-AI. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. arXiv:2501.12948, 2025. https://arxiv.org/abs/2501.12948
[6] DeepSeek-AI. DeepSeek-R1. Nature, 2025. doi:10.1038/s41586-025-09422-z
[7] DeepSeek-AI. Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention. arXiv:2502.11089, 2025. https://arxiv.org/abs/2502.11089
[8] DeepSeek-AI. DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models. arXiv:2512.02556, 2025. https://arxiv.org/abs/2512.02556
[9] DeepSeek-AI. DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence. arXiv:2606.19348, 2026. https://arxiv.org/abs/2606.19348
[10] DeepSeek-AI. DeepSeek-V3.1 官方模型卡. Hugging Face, 2025. https://huggingface.co/deepseek-ai/DeepSeek-V3.1
[11] DeepSeek-AI. DeepSeek-V3-0324 官方模型卡. Hugging Face, 2025. https://huggingface.co/deepseek-ai/DeepSeek-V3-0324
[12] DeepSeek-AI. DeepSeek-R1-0528 官方模型卡. Hugging Face, 2025. https://huggingface.co/deepseek-ai/DeepSeek-R1-0528
[13] DeepSeek-AI. DeepSeek-V4-Pro 官方模型卡. Hugging Face, 2026. https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro
[14] DeepSeek-AI. DeepSeek-V4-Flash 官方模型卡. Hugging Face, 2026. https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash
[15] DeepSeek-AI. DeepSeek-V4-Pro-0813 官方模型卡. Hugging Face, 2026. https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro-0813
[16] DeepSeek-AI. DeepSeek-V4-Flash-0731 官方模型卡. Hugging Face, 2026. https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash-0731
[17] DeepSeek-AI. DeepSeek-V4-Pro-DSpark 官方模型卡. Hugging Face, 2026. https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro-DSpark
[18] DeepSeek-AI. DeepSeek-V4-Flash-Vision-Exp 官方模型卡. Hugging Face, 2026. https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash-Vision-Exp
[19] DeepSeek-AI. DeepSeek-V4.1-Flash 官方模型卡. Hugging Face, 2026. https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
[20] DeepSeek-AI. DeepSeekMath-V2: Towards Self-Verifiable Mathematical Reasoning. Hugging Face, 2025. https://huggingface.co/deepseek-ai/DeepSeek-Math-V2
[21] DeepSeek. DeepSpec: Open-source speculative decoding toolkit. GitHub, 2026. https://github.com/deepseek-ai/DeepSpec
[22] DeepSeek-AI. DeepSeek-V4.1-Flash-1017 官方模型卡. Hugging Face, 2026. https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
[23] DeepSeek. DeepSeek-V4.1-Flash-1017: Wish-Driven Programming Made Real(官方发布说明). 2026-10-17. https://api-docs.deepseek.com/news/news261017
[24] DeepSeek. Models & Pricing(含 Search & Fetch 定价与 deepseek-flash 版本对应). 2026. https://api-docs.deepseek.com/quick_start/pricing
评论
填个昵称就能发,不需要注册或登录