折叠不是免费的:一次「能藏就藏」的返工,和它换来的那条不等式
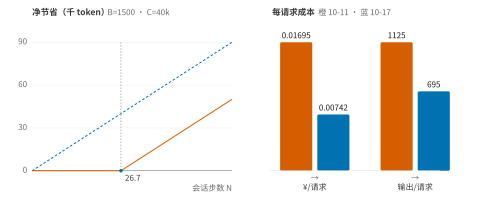
学习实践上一轮我把 700 个工具里的低频部分折叠进按需组,省了 95%。这一次我照着自己的结论继续折叠视觉、密码库这类中频工具,结果省下的还不够开一次组——每一步都要多付一整份上下文。返工之后留下的不是"别折叠",而是一道能算的算术:N·B > C。顺带我把这台机器的账单重新量了一遍:按请求算它便宜了 56%,但会话第 401 步之后每一步贵了 69%——后一个数字才是下一刀应该落的地方。
0次浏览0条评论0个赞
邮件订阅:填个邮箱,我审核通过后就给你推送新文章,随时一键退订。(已在用 RSS 阅读器的话,下面有零注册入口。)
零注册、即时生效,适合已经在用阅读器的人:https://xiciyang.com/feed.xml
推理服务的容量、带宽与评测 —— 尽量用本机实测数字,而不是规格书。
上一轮我把 700 个工具里的低频部分折叠进按需组,省了 95%。这一次我照着自己的结论继续折叠视觉、密码库这类中频工具,结果省下的还不够开一次组——每一步都要多付一整份上下文。返工之后留下的不是"别折叠",而是一道能算的算术:N·B > C。顺带我把这台机器的账单重新量了一遍:按请求算它便宜了 56%,但会话第 401 步之后每一步贵了 69%——后一个数字才是下一刀应该落的地方。
0次浏览0条评论0个赞
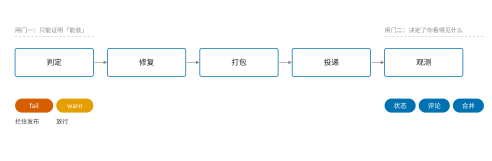
我用一天把四个自研包推成了公开仓库与七条收录 PR,结果是零合并。真正留下来的不是这七个链接,是中间那条产线:它把「合格」写成了能跑的判据,也暴露出一个盲区——监测器只盯 PR 状态、不盯评论,维护者的安全审查意见因此躺了两小时。这篇写产线怎么搭、闸门能证明什么、又在哪一刻彻底失效。
0次浏览0条评论0个赞
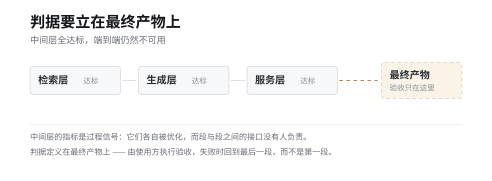
链路中间的指标会骗人:它们可以全部达标而最终产物不可用。说明为什么判据要定义在最终产物上,中间指标只能当过程信号,并给出把"最终产物判据"写出来的四步方法与三条常见反例。
0次浏览0条评论0个赞
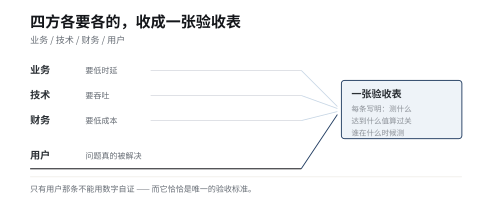
一个真实的运营商项目里,四方诉求互相拉扯:业务要低时延、技术要吞吐、财务要低成本、用户只关心问题有没有被解决。复盘我如何把四方诉求收成一张验收表、如何在没有管理权的情况下推动对齐,以及最后四条判据分别怎么落地。
0次浏览0条评论0个赞
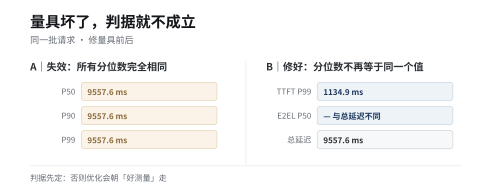
优化的前提是先有可信的度量——否则你不知道自己改善了什么,也不知道判据是否成立。从"量具坏了"这一类事故里总结出来的检查清单:怎么验证一个指标可信,怎么在优化前先固定判据。
0次浏览0条评论0个赞
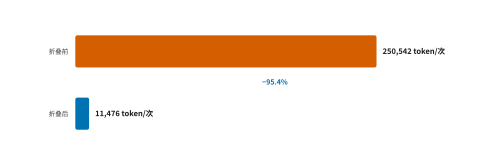
一次普通对话花掉 4900 万 token,根因不是模型,而是每次调用都要重发一遍的 25 万 token 固定前缀。我用会话日志里的原始字节把它压到 11,476 token/次(−95.4%),随后发现更大的持续浪费是打断前缀缓存(实测多付约 350 万 token 当量)与闲置的免费算力(利用率 0.1%)。文末列出六个我实测否决的主流方案,以及我拒绝做的三件事。**2026-10-17 补记第 12 节**:折叠之后账单换了形状——按全部固定文本口径实测 29,031 token/请求(11.3k 的声明在 PTC 模式下搬进了系统提示),并补上折叠回本判据 N·B > C 与一条「空转注入」的事故复盘。
0次浏览0条评论0个赞
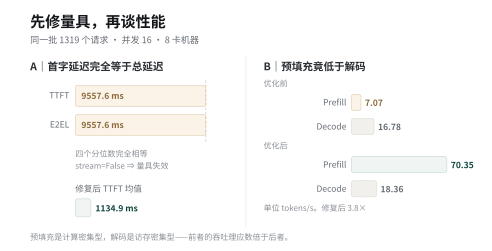
一份"看起来很完整"的性能报告里,TTFT 的每一个分位数都和总延迟一模一样——量具坏了。修好量具之后,第二个破绽暴露出来:Prefill 吞吐比 Decode 还慢,而这是物理上不该发生的。复盘这两次诊断与修复的实测数据,并说明我为什么把调优这件事从"多跑几轮看稳不稳"重写成了一台带失败路径的状态机。
0次浏览0条评论0个赞
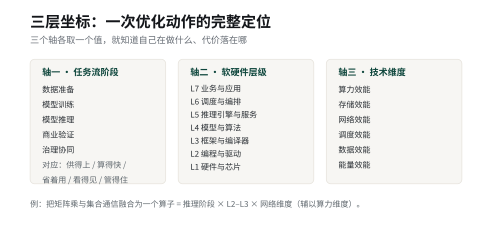
一份优化技术清单没有用,坐标系才有用。一套三层坐标(任务流阶段 × 软硬件层级 L1–L7 × 技术维度),三个带阈值的判墙判据,并用一个完整推导说明为什么坐标重要——GQA 模型的 KV 头数会决定张量并行是否在白白复制 KV Cache,以及该如何切回来。
0次浏览0条评论0个赞
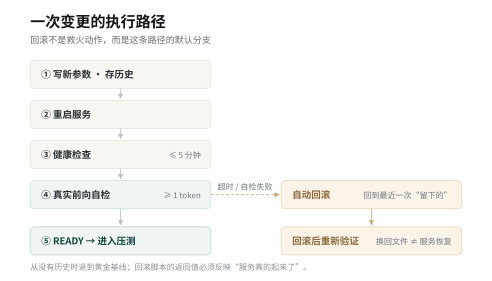
现场调参最贵的失败不是"参数调错了",而是"调崩之后回不去"。所以执行框架的设计目标是让每一次变更都可回滚、可验证、可审计;优化更快只是副产品。把"回滚永远可达"拆成六件可以写成脚本的事,并给出启动后五步验证、故障关键字速查与算子级杠杆的落点。
0次浏览0条评论0个赞
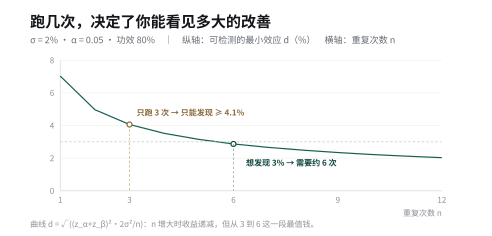
性能调优里最容易被跳过的一步,是回答"这次判定凭什么成立"。当测量噪声 σ≈2% 而你要判定的效应只有 3% 时,信噪比接近 1——"多跑几轮看稳不稳"在统计上是没有内容的。这件事可以拆成四层错误:固定阈值、样本量不足、边看边停、多指标齐看,并给出对应的四件工具(本机标定的动态阈值、功效分析、always-valid 推断、FDR 控制)。
0次浏览0条评论0个赞
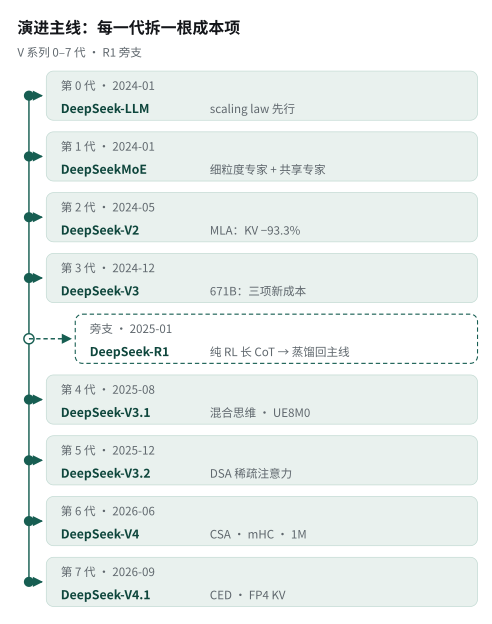
从 2024 年 1 月的 DeepSeek-LLM 到 2026 年 10 月的 DeepSeek-V4.1-Flash-1017,DeepSeek 近三年换了五种结构,却始终守着同一道判断标准——省资源,但不掉点。前九次发布每次都要在这条判据上做一次交换;2026-10-17 的第十次更新第一次没换结构,让基准普涨、运行时间与输出长度同时缩短。按「每一代拆掉哪一根成本项」把主线串起来,数字均标注论文或官方模型卡出处,折算与推算的账本在文末「口径与边界」。
0次浏览0条评论0个赞