插件、Skill、MCP、CLI:先判断这份能力该不该进模型上下文
专业洞察同一个能力做成插件和做成 CLI,代价差在每一步:插件的工具声明每次请求都在场,CLI 只在被调用时存在。按「谁决定调用时机、多久用一次、失败会污染谁」三个问题,把能力分到工具、Skill、MCP、套件、领域包与脚本六种形态,并给出动手前的三条验收。
0次浏览0条评论0个赞
邮件订阅:填个邮箱,我审核通过后就给你推送新文章,随时一键退订。(已在用 RSS 阅读器的话,下面有零注册入口。)
零注册、即时生效,适合已经在用阅读器的人:https://xiciyang.com/feed.xml
关于 DSH 这个 harness 本身:插件模型、工具契约、运行时与调试方法。
同一个能力做成插件和做成 CLI,代价差在每一步:插件的工具声明每次请求都在场,CLI 只在被调用时存在。按「谁决定调用时机、多久用一次、失败会污染谁」三个问题,把能力分到工具、Skill、MCP、套件、领域包与脚本六种形态,并给出动手前的三条验收。
0次浏览0条评论0个赞
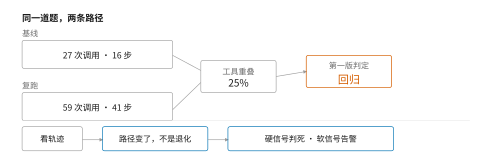
我给这台 agent 的改动加过很多能力,却只有一个六道合成题的行为闸门。真正的问题在落地五件测量工具那天暴露:重放闸门把四道真实任务里的两道判成回归,查下去发现坏的是判据,不是系统。这篇写这五件工具各自回答什么问题、什么时候触发、以及每件证明不了什么。
0次浏览0条评论0个赞
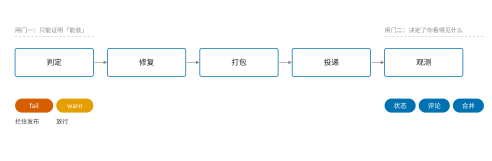
我用一天把四个自研包推成了公开仓库与七条收录 PR,结果是零合并。真正留下来的不是这七个链接,是中间那条产线:它把「合格」写成了能跑的判据,也暴露出一个盲区——监测器只盯 PR 状态、不盯评论,维护者的安全审查意见因此躺了两小时。这篇写产线怎么搭、闸门能证明什么、又在哪一刻彻底失效。
0次浏览0条评论0个赞
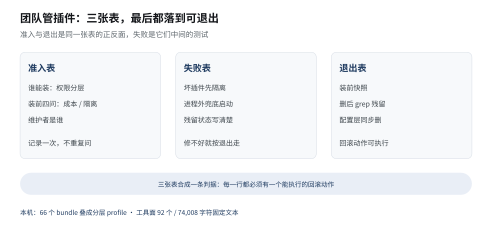
团队里第 3 个人装了一个插件,第 1 个人的会话行为跟着变了,却没人说得清是谁加的。团队治理的杠杆不在审批,而在退出路径:准入、失败、退出是三张表,衡量的是同一件事——每一行有没有一个能执行的回滚动作。
0次浏览0条评论0个赞
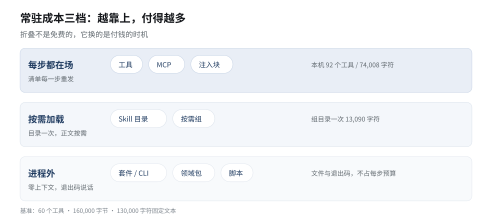
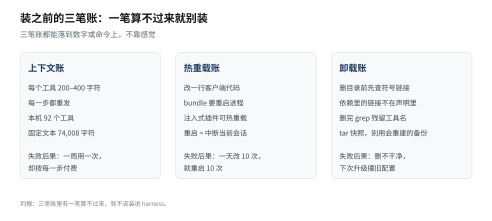
个人给自己加能力,装、写、接之间差的不是功能,而是三笔账:每个工具每步占多少上下文、改一次要不要重启、删掉要留多少尾巴。三笔账都能落到数字与命令上,有一笔算不过来,就不该装进 harness。
0次浏览0条评论0个赞
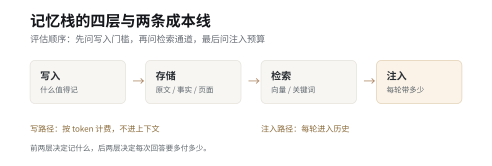
腾讯开源的 Hy-Memory 2.0 提供了完整的记忆分层与写入模型。评估后我们没有换栈:12 条真实查询的体检显示,覆盖率 8/12,向量召回 2/8,全文检索 7/8,瓶颈在检索通道与写入边界。
0次浏览0条评论0个赞
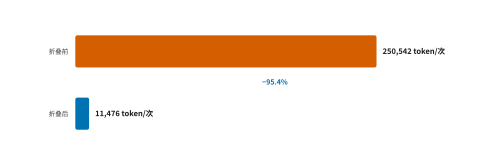
一次普通对话花掉 4900 万 token,根因不是模型,而是每次调用都要重发一遍的 25 万 token 固定前缀。我用会话日志里的原始字节把它压到 11,476 token/次(−95.4%),随后发现更大的持续浪费是打断前缀缓存(实测多付约 350 万 token 当量)与闲置的免费算力(利用率 0.1%)。文末列出六个我实测否决的主流方案,以及我拒绝做的三件事。**2026-10-17 补记第 12 节**:折叠之后账单换了形状——按全部固定文本口径实测 29,031 token/请求(11.3k 的声明在 PTC 模式下搬进了系统提示),并补上折叠回本判据 N·B > C 与一条「空转注入」的事故复盘。
0次浏览0条评论0个赞
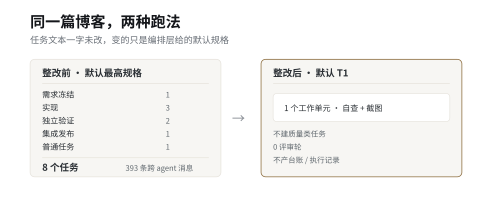
一篇博客被编排层拆成 8 个任务、产生 393 条跨 agent 消息。问题不在哪条门禁坏了,而在编排层根本没有「级别」这一维,于是最高规格成了默认值。复盘我怎么加上这一维、把「只能更轻」变成机器不变量,以及我为这个改动亲手造出、又被独立复核对出来的一个危险 bug。
0次浏览0条评论0个赞
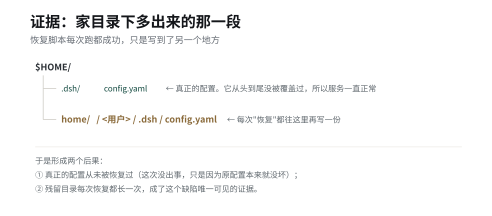
恢复机制存在了 9 天,日志显示它工作正常——但它一次都没真正生效过。根因是打包用相对路径、解压用 -C $HOME 的不匹配,产物是一段不该存在的 ~/home 目录。复盘这个静默失败,以及改完之后的 known-good 检查点与级联恢复设计。
0次浏览0条评论0个赞
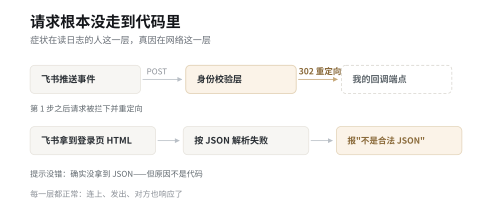
飞书回调配置全对、机器人一句话不回;浏览器镜像 HTTP 200、观察者计数正常、一帧都不出。两次都栽在同一件事上——把"接通了"当成"能用了"。用两条真实接入路径,把"约束在哪里""你看的是哪一份会话""什么才算成功"拆成三件可以独立回答的事。
0次浏览0条评论0个赞
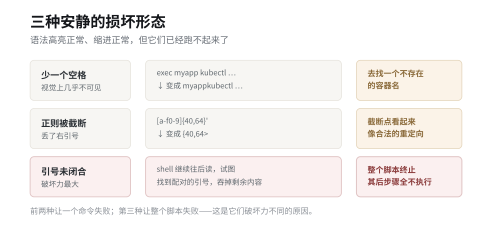
一段脚本只要没被真的执行过,它就只是文本——而文本会以非常安静的方式损坏:粘贴时丢一个空格、换行处截断一个字符、正则少一个右括号。用一个真实案例给出三关判据(能解析、能重复执行、失败可回滚),以及两处容易被忽略的部署约束。
0次浏览0条评论0个赞