改完提示词,凭什么知道没变差:五道可测闸门,和一次先坏掉的判据
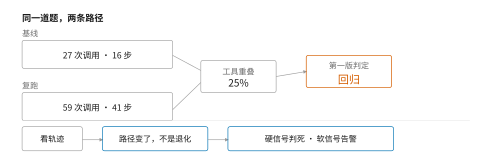
案例复盘我给这台 agent 的改动加过很多能力,却只有一个六道合成题的行为闸门。真正的问题在落地五件测量工具那天暴露:重放闸门把四道真实任务里的两道判成回归,查下去发现坏的是判据,不是系统。这篇写这五件工具各自回答什么问题、什么时候触发、以及每件证明不了什么。
0次浏览0条评论0个赞
邮件订阅:填个邮箱,我审核通过后就给你推送新文章,随时一键退订。(已在用 RSS 阅读器的话,下面有零注册入口。)
零注册、即时生效,适合已经在用阅读器的人:https://xiciyang.com/feed.xml
当模型开始调用工具、改写状态,评测与产品判断该怎么跟着变。
我给这台 agent 的改动加过很多能力,却只有一个六道合成题的行为闸门。真正的问题在落地五件测量工具那天暴露:重放闸门把四道真实任务里的两道判成回归,查下去发现坏的是判据,不是系统。这篇写这五件工具各自回答什么问题、什么时候触发、以及每件证明不了什么。
0次浏览0条评论0个赞
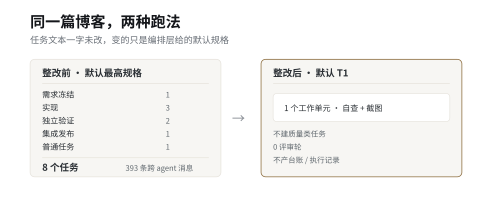
一篇博客被编排层拆成 8 个任务、产生 393 条跨 agent 消息。问题不在哪条门禁坏了,而在编排层根本没有「级别」这一维,于是最高规格成了默认值。复盘我怎么加上这一维、把「只能更轻」变成机器不变量,以及我为这个改动亲手造出、又被独立复核对出来的一个危险 bug。
0次浏览0条评论0个赞
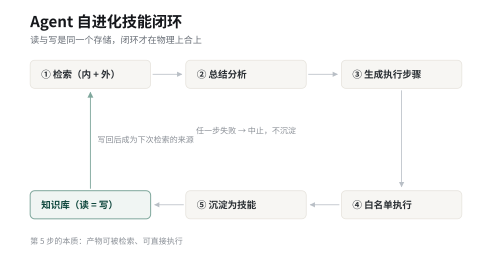
让 agent 自己长技能,真正的风险在于它把错的做法记成经验:技能库同时是它自己的判据来源,错一次会被记住很多次。我把它做通了(检索→计划→白名单执行→成功后蒸馏成技能写回同一个知识库),但通读代码后找到三处设计缺陷:白名单把解释器放了进去、自动沉淀默认开启、参数替换发生在分词之前。
0次浏览0条评论0个赞
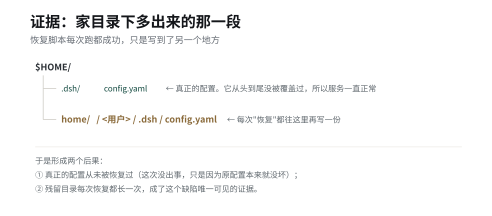
恢复机制存在了 9 天,日志显示它工作正常——但它一次都没真正生效过。根因是打包用相对路径、解压用 -C $HOME 的不匹配,产物是一段不该存在的 ~/home 目录。复盘这个静默失败,以及改完之后的 known-good 检查点与级联恢复设计。
0次浏览0条评论0个赞
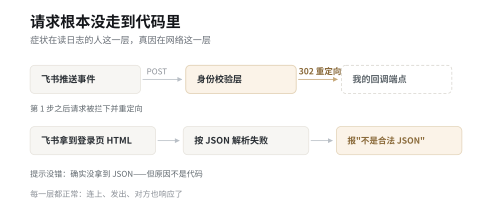
飞书回调配置全对、机器人一句话不回;浏览器镜像 HTTP 200、观察者计数正常、一帧都不出。两次都栽在同一件事上——把"接通了"当成"能用了"。用两条真实接入路径,把"约束在哪里""你看的是哪一份会话""什么才算成功"拆成三件可以独立回答的事。
0次浏览0条评论0个赞
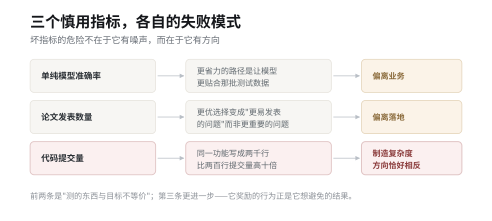
一个指标只要能被主动生产,它就会被生产。而 AI 岗位的关键能力恰好全都难以测量——于是人会用"容易测的量"替代,结果往往适得其反:"代码提交量"度量的是复杂度增长,激励方向与目标恰好相反。给出三个慎用指标及其失败模式、以行为锚定替代打分的做法,以及为什么岗位定义本身也有半衰期。
0次浏览0条评论0个赞
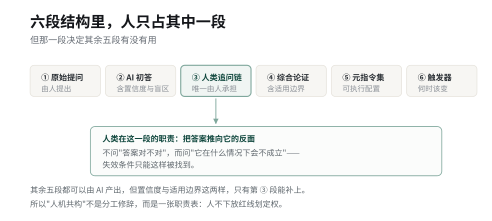
一次 AI 对话要变成可复用的资产,需要三件它通常不产出的东西——置信度、适用边界、可执行形式。一套六段式对话结构(原始提问 → 初答 → 人类追问链 → 综合论证 → 元指令集 → 自进化触发器)、追问链该推的三类问题,以及为什么最终形态必须是配置而不是散文。
0次浏览0条评论0个赞
一个自动化闭环最容易被漏掉的部分不是流程本身,而是"谁来验收、拿什么验收、不通过怎么办"。复盘两个真实系统的设计:三位一体对齐与不做清单,以及一套把"还行"变成数字的评分卡、五层监督与自动卡点——并给出一个关键判据:规则与机制的差别,在于有没有卡点。
0次浏览0条评论0个赞
有些判断听起来很像洞察,甚至能被数据支持,却无法指导任何动作——它们是把相关当因果的伪洞察。一套可复核的检验:三条判据(机制穿透性、可验证性、范式价值)、一条从噪声到结论的 SOP、五层递进的能力台阶,以及用技术/业务/资本三个视角对同一个判断做压力测试的方法。
0次浏览0条评论0个赞