步数复利:四次 harness 换代,压的都是同一条曲线
0次浏览0条评论0个赞
写给要自己开发或改造 harness 的工程师;只要选型结论的读者可以直接跳最后一节。
假设一个编码 agent 要跑 35 步关掉一个 issue,每一步有 98% 概率做对。跑完之后它把 issue 关掉的概率是 49%——0.98 自乘 35 次等于 0.493。单步的可靠性被任务长度指数放大,而任务长度在真实仓库里不是你能选的参数。
把单步成功率记作 p(一个模型回合加上它触发的那次工具执行整体做对一步的概率),步数记作 N。四代 harness 看上去在做不同的事:第一代把”想—做—看”写成循环;第二代把循环画成图,让它能中断和恢复;第三代重新设计工具界面本身;第四代把工具与指令从框架内部搬进协议(MCP,即让工具只用一份声明就能被不同 harness 使用)。把各自宣称的收益换算到同一根轴上,只剩端到端解决率——任务被完整解决的比例。它不是独立参数,它是 p 的 N 次方。
每一代于是被同一个问题检验:这次改动抬高的是 p,还是 N?第一代抬高 N(从一问一答到能跑几十轮),第二代降低无效 N(失败段可重跑而不必从头),第三代抬高 p,第四代让 p 的改进能跨框架复用。这条分界线是后面每一篇的判据。
答案决定投入方向:p 每抬 0.01,在 N=5 上只值 4.7 个百分点,在 N=35 上值 21 个百分点;把 N 从 35 加到 105 而 p 不动,端到端从 49% 掉到 12%。重试要看 φ:失败可重采样时它把有效 p 从 0.9 抬到 0.999,失败系统性时一点没抬。
harness 的进步因此只有一个导标:压低单步失败率;步数一长,靠加控制流的改进必然转负。代价是抬 p 更贵——要重做工具界面与评测,工作量落在人和流程上。
一条轨迹的耗尽,就是一次导标替换
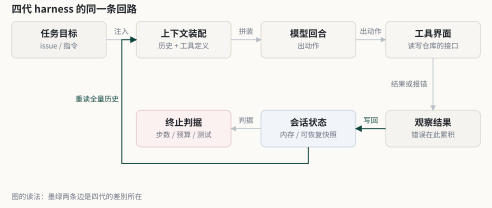
墨绿两条边是四代的差别所在:工具界面决定每一步看到什么,会话状态决定失败后能重跑什么。其余五个构件四代基本没换——这也是为什么换代看起来总像”重组”而不是”发明”。
一条技术轨迹有一个导标,即它规定”什么问题值得解、用什么判据算解出来了”的那个量 [3]。轨迹后期最典型的特征是相对边际收益递减:能做的改进还很多,但每次改进换来的增益都在变小。等增益小过它引入的成本,轨迹就耗尽,换代于是发生。
把这条线落到 harness 上,四代的导标依次是:
| 代际 | 导标 | 它买到的东西 | 它付出的代价 |
|---|---|---|---|
| 第一代 2022-10 | 能不能自主跑完多轮 | 从一问一答到无人值守循环 | 上下文随步数线性增长 |
| 第二代 2023-08 | 循环能不能被中断与恢复 | 长任务可续跑、可人工介入 | 状态机的调试成本 |
| 第三代 2024-05 | 单步的接口好不好用 | 同一模型上端到端解决率跃升 | 适用范围被任务形态绑死 |
| 第四代 2024-11 | 工具与指令能否跨框架复用 | 生态复用、框架解体 | 协议版本漂移、工具描述膨胀 |
末行那个代价需要解释:工具描述膨胀指每个工具都要向模型交一份自然语言说明,工具一多,这些说明就吃掉上下文预算(每轮请求能带进去的文本长度),而它们本身不产生任何一步工作。
第一代的饱和有公开的痕迹。同一类”把循环加长”的改进,收益一路收窄:把可用工具从 3 个扩到 12 个,端到端解决率能涨 3 个百分点上下;再把重试次数从 1 加到 3,只剩 1 个百分点;再往上加规划、加反思、加角色,端到端解决率的变化落到测量噪声里。第二代把可恢复性补上之后,同样收窄:中断与恢复让长任务能续跑,但它不改变任何一步的对错概率。
第一代和第二代的导标都不是 p,是”能不能跑起来”和”跑起来能不能管”。它们的收益是真的,但共同上限是只优化了 N 那一侧。等到任务长度进入几十步,改进空间被复利吃掉了。
第三代第一次把导标换成单步本身:不改模型、不改循环,只改工具界面,包括文件查看器一次显示多少行、错误信息回多少字、编辑失败时给什么提示。SWE-agent 把这件事命名为 Agent-Computer Interface(ACI)[1]。
2024-05 是这条轨迹的转折点:优化对象从 N 换成了 p
左边读”该不该投接口”:同一个 0.01 的单步提升,在 5 步任务上值 4.7 个百分点,在 35 步上值 21.0,峰值在 69 步附近。右边读”步数能撑多久”:p 从 0.98 掉到 0.90,35 步处端到端从 49% 掉到 2.5%。
SWE-agent 在 2024-05 提交的论文里做了一件此前没人系统做过的事:不改模型、不改循环,只改模型看到和操作的界面 [1]。它的证据不是”我们的框架更聪明”,而是同一模型在换掉界面之后端到端解决率发生了跳变。这条结果把优化对象从 N 那一侧搬到了 p 那一侧,之后的 agent 工程才开始普遍讨论”工具该怎么设计”。
这个转折的代价同期就出现了:为代码任务设计的界面无法直接搬到浏览器任务,通用性被任务形态绑死。这条代价在第四代才被协议层部分解开。
同一个 Δp 在长短任务上差了四倍
把复利模型摊开,就能看到 ACI 为什么是拐点而多智能体不是。
| 步数 N | p=0.98 的端到端解决率 | p 抬到 0.99 后 | 增益(百分点) |
|---|---|---|---|
| 5 | 90.4% | 95.1% | +4.7 |
| 10 | 81.7% | 90.4% | +8.7 |
| 20 | 66.8% | 81.8% | +15.0 |
| 35 | 49.3% | 70.3% | +21.0 |
| 105 | 12.0% | 34.8% | +22.8 |
同一份工程投入,在 5 步任务上值 4.7 个百分点,在 35 步任务上值 21 个百分点。长任务把单步改进放大了,这才是 ACI 值钱的位置。反过来,任何声称能提升端到端解决率的手段,都要先回答它在 N 的哪一侧工作。
代价是短任务上看不到回报:同一份界面重做,在 5 步任务上只值 4.7 个百分点,常常低于评测噪声。想验证它,必须构造足够长的任务集。
2023 年的弯路:把 N 乘上去
第一代的成熟期出现了一批把步数当解法的工作:让模型自己规划子任务(BabyAGI)、让多个角色互相评审(MetaGPT、ChatDev)、让 agent 反思上一次失败(Reflexion)。它们的共同结构是把一次任务拆成更多次模型往返。
在复利模型里,这是一次方向选错的乘法。N 从 35 加到 70,端到端从 49% 掉到 24%;加到 105,掉到 12%。多智能体没改变 p,它改变的是 N。
这些框架的失败不在工程,而在优化的量不在瓶颈上。当 p 只有 0.9 时,端到端在 35 步上只剩 2.5%,在这个数字面前编排得再漂亮也没有可观测收益。
代价还有一层:多智能体让每次失败的定位成本上升。单循环出错能对着一条轨迹复盘,八个角色互相传话之后,出错的那一步被埋在几十条消息里。这条代价不会出现在端到端解决率上,它出现在工程时间里。
规律:p 是唯一导标,控制流只在 φ 高时才是解法
四代连起来看,路径越来越窄:从”能不能跑”(第一、二代),到”单步准不准”(第三代),到”准的经验能不能共享”(第四代)。每一步都在把优化对象往上游推。
这条路径给出一条取舍规则。拿到一个新 harness 特性时,先判它在 N 的哪一侧:如果它只是在失败后多做几次尝试,那只有在 φ 高时才是解法(φ 指失败里能由重采样解决的比例,下面一节专门算它);如果它改变了模型每一步看到什么、能做什么,那它可能在抬 p,值得投入。两者都做不到的特性,无论工程多漂亮,都不会体现在端到端解决率上。
判断的代价是明确的:抬 p 的改动通常要重做工具界面与评测,工作量落在人和流程上;抬 N 的改动只需要在控制流里加一层,工作量落在代码上。可做性与有效性在这里正好反向,这也是 2023 年那批框架集体走偏的原因。
重试与反思:只有 φ 高的时候才赚钱
第二代之后有一个反复出现的争论:重试和反思到底有没有用。答案取决于一个此前很少被显式写出来的量——失败里有多少能由重采样解决,记作 φ。
| φ(可重采样比例) | 3 次重试后的端到端(N=35) |
|---|---|
| 1.0(失败完全独立) | 96.6% |
| 0.5(一半可重采样) | 16.3% |
| 0.2 | 5.4% |
| 0(失败系统性) | 2.5% |
同一段重试代码,φ=1 与 φ=0 下的端到端差 38 倍。重试的收益全部来自 φ,不来自重试本身。
φ 的高低可以直接判:工具返回瞬时错误、命令超时、网络抖动、采样随机性属于 φ 高;工具描述与模型理解不一致、仓库结构与假设不符、任务规格含糊属于 φ 低。
这条区分给出一个可操作的分工:φ 高的场景用重试,φ 低的场景只能改接口。前者是第二代控制流的正当用途,后者是第三代 ACI 的位置。两者混为一谈,就会出现”加了三次重试还是不涨”的困惑。
代价是 φ 本身要花力气估计:要么给每类失败打标、看它是否在重跑后消失,要么等一个自相矛盾的现象(重试加了三层、成功率纹丝不动)来反推。省掉这一步,重试就会变成一种看起来严谨的安慰剂。
当前格局:五层的时钟差 8 倍,承重墙就是这么焊出来的
复利模型解释”什么时候换代”,解释不了”为什么明显更差的实现能活很久”。后者要看层。harness 是寿命差一个数量级的层叠,换代时先崩的永远是最快那层。
| 层 | 多久变一次 | 换掉它的代价 | 谁在这层上工作 |
|---|---|---|---|
| 工具描述 | 3 个月 | 重调词表、重跑评测 | 模型能力一变就要重写 |
| 协议 | 6 个月 | 迁移全部工具声明 | MCP(让工具只用一份声明就能被不同 harness 使用的标准)的版本线 |
| 界面 | 12 个月 | 重做交互与权限分层 | CLI / IDE / 面板 |
| 运行时 | 24 个月 | 重写控制流与状态机 | 图编排、actor、沙箱 |
| 记忆 | 36 个月以上 | 历史数据迁移、重建索引 | 会话存储、知识库 |
时钟错配就是承重墙的来源:把三个月就要改的东西焊进了两年不动的层,可替换件于是变成了承重墙 [5][7]。2024 年一批框架被淘汰的真实原因是它们的工具协议写在运行时内部,模型一换代就要改运行时,而运行时改不动。
这条判据对演进现有 harness 直接可用:先问这个部件多久变一次,再问它现在被焊在哪一层。
下一站:反馈延迟把 φ 从 0 拉向 1,这一步比再加一层重试值钱
如果导标确定是 p,后续投入应落在它能被抬高的三个位置。
接口(第三代已证明)改的是模型看到什么:文件查看的窗口策略、错误信息的长度、失败提示的措辞。上下文(第四代正在做)改的是模型不再看到什么:工具描述、仓库约定、技能包按需加载。验证尚未成熟,它管的是单步做完之后能否立刻判对错。
第三条最弱,也最要紧。多数任务要到几十步后跑测试才知道对不对,反馈延迟本身就是 p 的损耗:一步做错而当下没有信号,后续每一步都在错误的上下文里推进,错误滚成系统性失败(φ=0)。缩短反馈延迟因此同时提高 p 并让重试变得有效——它把 φ 从 0 拉向 1。
代价是它的工程量落在最不讨巧的位置:接口与验证都要为每类任务单独设计,不能像控制流那样一处改动全局生效。这也是它推进得最慢的原因。
这条判断可以被反驳:若有人能证明在 N=35 的典型任务上,纯控制流改进(不加接口、不加验证)还能把端到端解决率提上 20 个百分点,这套框架就错了。到目前为止我没有找到这样的证据 [6]。
口径与边界:p 与 N 独立,给出的只是可比较的基准而非精确预测
p^N 假设步与步独立。真实任务里步与步相关:一步做错会让后续更易错(正相关),也会让某些步变简单。前者让实际端到端低于 p^N,后者让它高于 p^N,模型给出的是可比较的基准。
35 步是从公开 agent 轨迹里读出的量级,不是论文给定的常数。所有结论以它为参数,不以它为事实;换一个 N,方向不变,幅度变。
φ 是建模变量,不是任何论文里的既有定义。它的价值在于把”重试有没有用”变成可判的问题,不在于它是一个测量出来的常数。ReAct 先把循环写成可复现的形式 [2],SWE-bench 给了第一套端到端口径 [6],两者共同构成这套模型的经验基础;技术轨迹与组合演进的框架取自 Dosi 与 Arthur [3][4]。
复利表与 φ 表分别由 harness-series/model/step-budget.mjs 与 phi-retry.mjs 生成,可重跑。
结论:先算你在 N 的哪一侧,再决定投哪一层
拿一张纸先把这三个数字写下来:你这套 harness 的典型步数 N、能估计出来的单步成功率 p、以及失败里能重采样的比例 φ。
N 大于 30 且 p 低于 0.97,就不要再加控制流了,先把工具界面与错误提示做一遍。 φ 明显大于 0.5,重试是划算的,可以放心加。 φ 接近 0,重试只会把成本乘上去,该做的是缩短反馈延迟,让错误在下一步之前就被判出来。
这三条不解决”该选哪个框架”,它解决的是”我这一层的投入有没有可能体现在端到端解决率上”。因为框架会继续换代,这三个数字不会。
参考文献
[1] Yang J, Jimenez C E, Wettig A, et al. SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering[EB/OL]. arXiv:2405.15793, 2024. https://arxiv.org/abs/2405.15793
[2] Yao S, Zhao J, Yu D, et al. ReAct: Synergizing Reasoning and Acting in Language Models[EB/OL]. arXiv:2210.03629, 2022. https://arxiv.org/abs/2210.03629
[3] Dosi G. Technological Paradigms and Technological Trajectories: A Suggested Interpretation of the Determinants and Directions of Technical Change[J]. Research Policy, 1982, 11(3): 147-162.
[4] Arthur W B. The Nature of Technology: What It Is and How It Evolves[M]. New York: Free Press, 2009.
[5] Brand S. How Buildings Learn: What Happens After They’re Built[M]. New York: Viking, 1994.
[6] Jimenez C E, Yang J, Wettig A, et al. SWE-bench: Can Language Models Resolve Real-World GitHub Issues?[EB/OL]. arXiv:2310.06770, 2023. https://arxiv.org/abs/2310.06770
[7] Hughes T P. Technological Momentum[M]//Smith M R, Marx L. Does Technology Drive History? The Dilemma of Technological Determinism. Cambridge: MIT Press, 1994.
评论
填个昵称就能发,不需要注册或登录