第三代拨款给了接口:SWE-agent 只改工具界面,就把解决率从 11% 抬到 18%
0次浏览0条评论0个赞
写给要自己改造 harness(模型外面那一层:循环、工具、上下文怎么拼、失败怎么处理)的工程师:这一篇解剖的是一代,不是一时。只要结论的可以直接跳到最后一节。
2024 年 5 月,SWE-agent 的论文报告了一组对照:同一个模型,只是把”模型怎么看到仓库、怎么改文件”重新设计了一遍,SWE-bench Lite 上的解决率从 11.00% 抬到 18.00% [1](Lite 是官方从完整集里筛出的 300 例子集,用来降低成本与噪声)。论文把被改动的这一层命名为 Agent-Computer Interface(ACI)——agent 与计算机之间的接口,对应人机交互里的那一层 [1][14]。
同期大部分 agent 工作的方向相反:加编排、加角色、加反思。那一条路的效果在总纲里算过——它把步数 N 乘上去,而单步成功率 p 不动。
ACI 这一代的意义在于它第一次把优化对象换成了 p 本身:这一代只认一个量——同一模型下的端到端解决率,其余指标(步数、成本、工具数)都被当成它的成本项。它给出的六个设计点,每一条都能对应到一组消融数字,也都有明确的代价。读法就一条:先看它把哪件东西换掉了,再看换掉之后解决率动了多少,最后看代价落在谁身上。
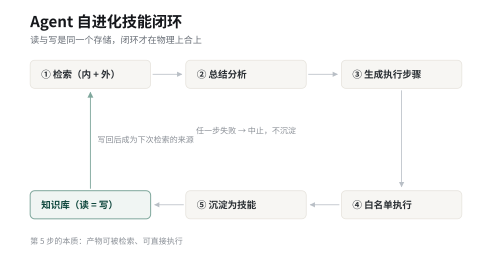
ACI 换的是图里右上那条边——工具界面。循环没动、会话状态没动、终止判据没动,只把”模型怎么读写仓库”重做一遍,端到端解决率就动了 5.3 个百分点以上。
2024-05 的分界线:先把界面做对,再谈编排
SWE-agent 论文 v1 于 2024-05-06 提交,它首次把”界面本身”提成可以用消融(一次只拆掉一处、看解决率掉多少)来验证的设计对象 [1][14]。在这之前,窗口大小、错误回显格式这类决定散落在各项目的 README 里,没人拿数字验证过;转折之后,这些细节开始被当成有消融支撑的工程决定。那批消融里最锋利的三个数字如下。
消融:每一处”少给一点”都换来更多解决率
论文的 Table 3 把六个设计点逐个拆开,都在 Lite 子集上测 [1]。
| 改动 | 结果(Lite 解决率) | 与基准的差 |
|---|---|---|
| 基准(edit + lint + 窗口 100 + last-5) | 18.0% | — |
| 去掉 lint guardrail | 15.0% | −3.0 |
去掉 edit 命令(只能整文件重写) | 10.3% | −7.7 |
| 窗口改成整文件 | 12.7% | −5.3 |
| 窗口改成 30 行 | 14.3% | −3.7 |
| 搜索改成交互式迭代(逐条 next) | 12.0% | −6.0 |
| 历史改成全量而非 last-5 折叠 | 15.0% | −3.0 |
三处最值钱的改动都在”减少模型要处理的量”上:edit 命令(+7.7)、窗口取 100 行而非整文件(+5.3)、搜索一次给完而非迭代(+6.0)。所以这一代的规律可以先给出:在 p 的瓶颈上,“少给模型一点”比”给模型更多能力”更值钱;后面几节都是这条规律的具体形态与它付的代价。
窗口那一行还有一组更锋利的对照:在同一模型上把窗口从 100 行放宽到 200 行,dev 集上解决率从 15.1% 掉到 10.8%(Table 5)[1]。给得更多,结果更差。 这与”上下文越多越好”的直觉相反,原因是模型要在更长的输出里定位,而定位本身就是失败来源。
规律先行:每一处”少给模型一点”都换来 3 到 8 个百分点
论文给出的 ACI 是六个具体决定 [1]。它们的共同形状是:限制模型能看到的量,并在它犯错之前拦住它。
命令集只有十来个,全部围绕”看—改—交”:open、goto、scroll_up、scroll_down、search_file、search_dir、find_file、edit n:m、create、submit(Table 4, p.16)[1]。没有 shell 直通,没有任意 API。少命令意味着模型不需要在几十个动作里选,选择本身是失败来源。
文件查看窗口固定 100 行、翻页步长 100 行,每次输出都带上总行数、上下各省略了多少行、以及真实行号(§3, Fig. 3a)[1]。行号是关键:edit n:m 直接复用查看器给出的行号,模型不需要自己数。
搜索上限 50 条,超限时不返回截断结果、而是要求重写查询(§3、§A.1)[1]。这是把”结果太多”从模型的判断问题变成了接口的拒绝。
编辑失败要回显三段:失败位置、附近的原文、以及为什么匹配不上(§A.1, Fig. 11)[1]。错误信息的作用是下一步的输入,而非给人看的日志。
最后是 guardrail:编辑落盘前跑 flake8 --isolated --select=F821,F822,F831,E111,E112,E113,E999,E902,有输出就回滚(§A.1, p.18)[1]。这组规则全是”未定义名字 / 语法错误”一类,能在模型看到结果之前拦掉。
换掉的是”自由 shell”,留下的是循环本身
把它放回时间轴,这一代换掉的东西很具体:第一代与第二代给模型的是自由 shell 加一堆工具定义,模型自己决定调用什么、自己解析输出;ACI 把这一步收窄成十来个语义化命令,把”怎么读仓库”从模型的策略问题变成接口的固定动作。
原样保留的是循环本身:想—做—看的结构没变,步数没有减少,编排没有变复杂。这也是它便宜的原因——不用重写运行时,只换工具面。
51.7% 的轨迹至少错一次编辑,错一次就把 90.5% 打成 57.2%
论文还报告了一组少被引用的数字:51.7%(1,185/2,294)的轨迹里至少出现过一次失败编辑;单次编辑的最终成功率是 90.5%,而一旦出现过一次失败编辑,成功率掉到 57.2%(§5.2)[1]。
这两个数字合起来解释了 ACI 的形状。单步成功率 90.5% 看起来很高,但在几十步的任务上,一次失败编辑就把后续每一步的条件概率改写。ACI 里的行号复用、三段式错误回显、lint 前置,本质上都在做同一件事:把”编辑失败”从一次静默的状态污染变成一个立刻可见、可恢复的事件。
这也给出与总纲的连接:这些设计做的是把 φ 从 0 拉向 1——让失败变成可重采样的,而不是让重试变多。
编辑格式换了四代:容错写进接口比写进提示有效 9 倍
Aider 走的是同一条路,只是它优化的对象更窄:编辑格式本身。它的演进有明确的版本锚点——整文件重写 → SEARCH/REPLACE 块(v0.16.0 把”edit block”改名以抑制畸形块)→ unified diff(2023-12-21 公布,v0.19.0 起对 gpt-4-1106-preview 默认)→ architect/editor 拆分(v0.58.0)[9][5][6]。
官方没有”udiff 失败率”这个指标,但有两个可核对的量。一是编辑排行榜的格式遵从率:gpt-4-1106-preview + udiff 有 65.4% 做对、92.5% 格式正确 [10]。二是两条反向消融:去掉”high-level diff”提示会让编辑错误增加 30–50%;关掉弹性 apply(归一化、补漏的 +、相对缩进匹配、拆大 hunk)在 Exercism 上编辑错误增加 9 倍 [5]。
这两条消融说的是同一件事:容错写在接口里比写在提示里有效。关掉弹性 apply 之后接口不再容忍模型的格式偏差,错误因此直接翻倍。
代价:适用范围被任务形态绑死
ACI 的收益具体,代价也具体。
上下文被接口形状决定。 窗口 100 行优于整文件,代价是模型常看不到要改的那一段,需要额外的 goto/open 往返 [1]。省下的错误变成了多花的步数。
测试不可见。 SWE-bench Verified 的存在本身就说明原数据集里有大量”没有附加信息就不可解”的题 [3];Anthropic 的 harness 报告把 hidden tests 列为四项挑战之一——模型看不到判分测试,常自以为修好而实际没过 [11]。判分环境自身也会错,报告里记录过 install patch 被应用两次这类”模型做对但判失败”的情况 [11]。
仓库存位靠交互式搜索。 搜索本身有失败模式:迭代式搜索比不搜索还差(12.0 对 15.7),因为模型会逐条 next 到底 [1]。
跑一次很贵。 OpenHands 全量 2,294 例约 US$6.9k、Lite 约 US$600 [2];SWE-agent 全量均摊 US$1.59/例 [1]。Devin 报告里 72% 的通过测试耗时超过 10 分钟 [13],CI 时长直接限制可迭代次数。
复现不确定。 Aider 实测同一请求在 temperature=0 下仍产生 5–10 种不同响应,个别题”在气泡上”决定成败 [10]。
这些代价共同指向一个问题:ACI 是为代码任务设计的。一个为代码设计的窗口策略搬到浏览器任务上不成立,反过来也一样。第四代的协议层要解的正是这个——把”界面”从框架内部搬出来,让它能按任务类型换。
结论:该改界面时加编排是白花钱,三条判据能省下 5 个百分点
判据可以直接写成三条。
同一模型上,工具界面的改动能带来两位数的解决率变化(18.0 对 12.7 是 5.3 个百分点,占基准的 29%),而加一层编排通常带来的是步数增长。
如果一次改动让模型看到更多(更大窗口、全量历史、更多工具),要先假设它变差,再用数字推翻这个假设。窗口 100 → 200 掉 4.3 个百分点就是反例。
如果一次改动让模型少做判断(行号复用、错误三段回显、搜索超限就重写),它大概率在抬 p。这三条都比”再包一层 agent”便宜,代价是它们只对一类任务成立——换任务形态就得重做一遍界面,而这正是第四代要解的问题。
口径与边界:18% 与 70.3% 差 52 个百分点,因为口径不同
SWE-bench 上的成绩有三类来源,混着引用会得出错误结论。
SWE-agent 的 12.47%/18.00% 是论文自测(全量/Lite,2024-05-06 v1)[1]。Aider 的官方数字只有全量 18.9%(2024-06-02)与 Lite 26.3%(2024-05-22)两项,它在 Verified 官方榜上没有任何条目 [7][8][4]。
Anthropic 报告的 49.0% / 63.7% / 70.3% 是自建 scaffold(bash + str_replace_editor)的成绩,不是 Claude Code 这个产品的分数——Claude Code 本身不发布 SWE-bench 数字 [11][12]。官方榜上可查的条目另有记录:SWE-agent + Claude 3.5 Sonnet 33.6%、OpenHands + CodeAct v2.1 53.0%、Factory Code Droid 37.0%(标 Attempts 2+)[4]。
窗口消融的 15.1% 对 10.8% 只跑了 dev 集的 37 例(Table 5,T=0)[1],样本小,方向可信、幅度要留余量。
ACI 六个设计点里,“错误信息长度控制”论文只给了行数与条数上限(last-5 折叠、格式错误只留首条、连续 3 次终止),字符级或 token 级阈值论文未报告 [1]。把这一项写成具体数字就是编造。
参考文献
[1] Yang J, Jimenez C E, Wettig A, et al. SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering[EB/OL]. arXiv:2405.15793, 2024. https://arxiv.org/abs/2405.15793
[2] Wang X, Chen B, Liu Y, et al. OpenHands: An Open Platform for AI Software Developers as Generalist Agents[EB/OL]. arXiv:2407.16741, 2024. https://arxiv.org/abs/2407.16741
[3] OpenAI. Introducing SWE-bench Verified[EB/OL]. 2024-08-13. https://openai.com/index/introducing-swe-bench-verified/
[4] SWE-bench 官方排行榜[EB/OL]. https://www.swebench.com/
[5] Gauthier P. Unified diffs make GPT-4 Turbo 3X less lazy[EB/OL]. 2023-12-21. https://aider.chat/2023/12/21/unified-diffs.html
[6] Gauthier P. Separating code reasoning and editing[EB/OL]. 2024-09-26. https://aider.chat/2024/09/26/architect.html
[7] Gauthier P. How aider scored SOTA 26.3% on SWE Bench Lite[EB/OL]. 2024-05-22. https://aider.chat/2024/05/22/swe-bench-lite.html
[8] Gauthier P. Aider is SOTA for both SWE Bench and SWE Bench Lite[EB/OL]. 2024-06-02. https://aider.chat/2024/06/02/main-swe-bench.html
[9] aider. Release history[EB/OL]. https://aider.chat/HISTORY.html
[10] aider. Options reference[EB/OL]. https://aider.chat/docs/config/options.html
[11] Anthropic. Claude SWE-Bench performance[EB/OL]. https://www.anthropic.com/research/swe-bench-sonnet
[12] Anthropic. Claude 3.7 Sonnet and Claude Code[EB/OL]. 2025-02-24. https://www.anthropic.com/news/claude-3-7-sonnet
[13] Cognition. SWE-bench technical report[EB/OL]. 2024-03-15. https://cognition.ai/blog/swe-bench-technical-report
[14] SWE-agent Docs. Agent Computer Interface (ACI)[EB/OL]. https://swe-agent.com/latest/background/aci/
评论
填个昵称就能发,不需要注册或登录